

データフロー図は、システム分析と設計の基盤となります。これらは、情報がシステム内をどのように移動するかをマッピングし、プロセス、データストア、および外部との相互作用を強調します。適切に構築されたDFDは、開発者と利害関係者の両方にとって複雑なロジックを明確にします。しかし、正確な図を作成するには規律が必要です。多くのアナリストは、モデルの整合性を損なう特定の罠にはまります。
これらの落とし穴を理解することは、システムの信頼性を維持するために不可欠です。このガイドでは、頻繁に起こる7つのエラーとその効果的な修正方法について詳述します。私たちは各ミスの理論的な影響を探求し、改善のための実践的なガイダンスを提供します。
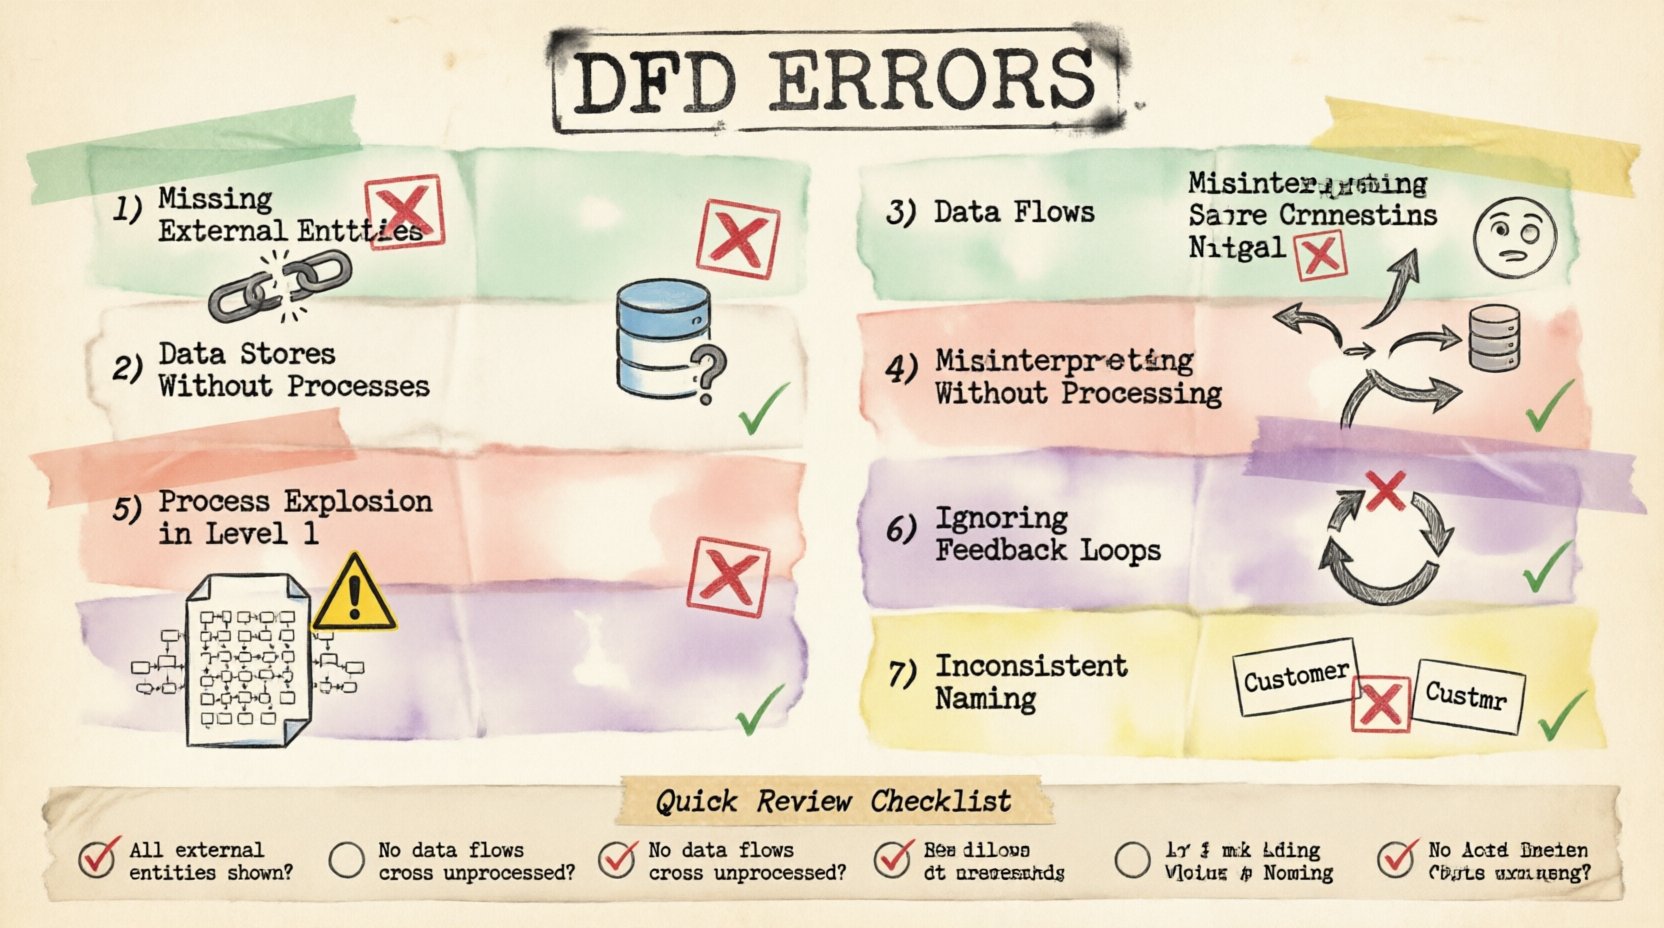
1. 外部エンティティの欠落 🚫
最も基本的な誤りの一つに、外部エンティティを省略することがあります。外部エンティティは、システム境界の外にあるデータのソースまたは宛先を表します。これらはユーザー、他のシステム、または組織である可能性があります。DFDがデータがどこから始まり、どこに最終的に到達するかを示さない場合、図は不完全なものになります。
トランザクション処理システムを考えてみましょう。もし図が税金の計算を示しているが、顧客が注文を送信する様子を示していない場合、フローは断絶しています。同様に、システムが確認メールを送信する場合、メールサーバーは外部エンティティとして表現されるか、少なくともそのアクションは明確な出力にリンクされる必要があります。これらの境界がない場合、システムの範囲は曖昧なままです。
- 影響:開発者は、決して到着しないデータを期待するプロセスを構築する可能性があります。
- 修正:ソフトウェアと相互作用するすべてのアクターまたはシステムを特定してください。
- 視覚的な手がかり:エンティティを明確に示すために四角形を使用してください。
常に、すべてのデータフローに開始点と終了点があることを確認してください。図内の線は単に空白で終わることはできません。それはプロセス、データストア、または外部エンティティに接続されなければなりません。
2. プロセスのないデータストア 🗄️
データストアは永続的なストレージを表します。これらは後で検索するための情報を保持します。データストアが存在するが、それを読み取るまたは書き込むプロセスがない場合、重大な間違いが発生します。これはモデル内に「ブラックホール」または到達不可能なアーカイブを作成します。
図にデータベーステーブルが定義されているが、それToUpdateするプロセスが示されていない場合、そのストレージは論理的に切断されています。逆に、プロセスがストアに書き込むが、誰もそれを読み取らない場合、データは目的を果たしません。これは、アナリストがユーザーインターフェースに焦点を当ててバックエンドの永続化層を忘れるときにしばしば起こります。
これを修正するには、すべてのデータストアを追跡してください。少なくとも1つの入力フローと1つの出力フローがあることを確認してください。これにより、データが作成され、利用されることが保証されます。これは、システムアーキテクチャ内の情報のライフサイクルを検証します。
3. 処理なしで交差するデータフロー 🔄
データフローはプロセスにのみ接続されるべきです。一般的な誤りは、1つのデータストアから別のデータストアへ、または外部エンティティから別のエンティティへ直接線を引くことで、処理ロジックをバイパスすることです。
有効なDFDでは、データは変換されなければなりません。データがソースから宛先へ移動する際、何らかのものがそれに対して作用する必要があります。プロセスはこの変換を表します。データが2つのストア間で直接流れる場合、それは論理なしの自動同期を意味し、複雑なシステムではほとんど正確ではありません。
| 誤ったフロー | 正しいフロー |
|---|---|
| エンティティ → データストア | エンティティ → プロセス → データストア |
| データストア → データストア | データストア → プロセス → データストア |
| エンティティ → エンティティ | エンティティ → プロセス → エンティティ |
すべての矢印がプロセスボックスを通過することを保証することは、モデルの論理的整合性を維持します。これはアナリストに、データが転送中に何が起こるかを定義させることを強制します。
4. データストア接続の誤解 📉
もう一つの微妙な点は、データストアに対するデータフローの方向です。プロセスはストアに書き込み、そこから読み取ることができます。しかし、アナリストはしばしば矢印の方向を混同します。データが書き込まれるときは矢印がストアに向かい、データが読み取られるときは矢印がストアから離れるべきです。
これらの矢印を逆転させると、システムの状態について混乱が生じます。プロセスは結果を保存するのか、それとも結果を取得するのか?明確な表記法が不可欠です。いくつかの手法では、読み取り操作と書き込み操作に異なる表記法を要求しますが、使用する特定の標準に関わらず、一貫性が重要な要件です。
データストアへのすべての接続を見直してください。操作を明確にするために必要に応じてフローにラベルを付けます。例えば、「レコードの更新」や「残高の取得」など。これにより、開発フェーズでの曖昧さが減ります。
5. レベル1図におけるプロセスの爆発 🧩
DFDは階層的です。コンテキスト図はシステムを単一のプロセスとして示します。レベル0はこれを主要なサブプロセスに分解します。レベル1はこれらのサブプロセスをさらに分解します。頻繁な誤りは、レベル1に詳細を詰め込みすぎることです。
レベル1の図が数十の小さなプロセスで混雑すると、高レベルのマップとしての価値を失います。それはデータフロー図というよりもフローチャートになります。レベル1の目的は、個々の計算ではなく、主要な機能モジュールを示すことです。
プロセスボックスに5〜7以上のサブプロセスが含まれている場合、それは別の図に分解されるべきです。これにより、視覚的な階層が清潔に保たれます。これにより、視聴者は細部に迷い込むことなく、システムの構造を理解することができます。
- 目安:スクロールなしで1枚の標準ページに図を描くことができる場合、それはおそらく適切です。
- 目標:詳細さと可読性のバランスを取る。
6. フィードバックループと制御データの無視 🔄
システムはほとんどが線形ではありません。動作を調整するためにフィードバックが必要になることがよくあります。よくある見落としは、制御フローやフィードバックループを図示しないことです。例えば、ユーザーがエラーメッセージを受け取り、データを再入力する場合があります。このループは可視化されなければなりません。
図に入力から出力への直線が描かれている場合、それは一方通行であることを示唆します。実際のシステムには、検証、拒否、再処理が含まれます。これらのループを無視すると、エラー発生時にシステムがクラッシュしたり、予期せぬ動作をしたりする原因となります。
データが修正のために戻される経路を含めてください。入力を検証するプロセスを示し、例外を処理するプロセスも示してください。これにより、現実の使用シナリオを考慮した堅牢なモデルが作成されます。
7. 命名規則の不整合 📝
明確さは一貫した言語に依存します。図の一部分で「ユーザー」と使い、別の部分で「顧客」と使うと、読者を混乱させます。同様に、「データを取得する」という名前のプロセスの隣に「情報を取得する」という名前のプロセスがあると、それらが異なることを示唆してしまいます。
用語を標準化してください。プロジェクト用の用語集を作成し、それに従ってください。データフローは名詞で命名すべきです(例:「注文詳細」)、一方、プロセスは動詞と名詞の組み合わせで命名すべきです(例:「合計を計算する」)。
一貫性はコミュニケーションを助けます。開発者が図を読む際、用語の意味を推測する必要があってはなりません。それは、開発サイクルの後半での誤解や手戻りのリスクを減らします。
エラーがシステム設計に与える影響 📊
なぜこのレベルの精度が重要なのでしょうか?DFD(データフロー図)におけるエラーは、ソフトウェア開発ライフサイクル全体に波及します。エンティティが欠落している場合、API エンドポイントが欠落する結果になるかもしれません。データフローが破損している場合、本番環境でヌルポインタ例外が発生する原因となる可能性があります。
さらに、保守が困難になります。ドキュメントがコードと一致しない場合、将来のエンジニアは構築するよりも推測する時間の方が多くなります。DFD のミスを早期に修正することは、デプロイされたバグを修正するよりもはるかに安価です。
確認チェックリスト ✅
図を確定する前に、この確認リストを確認してください:
- すべての外部エンティティが定義され、ラベル付けされていますか?
- すべてのデータストアに読み取りおよび書き込みのアクセス権がありますか?
- すべてのデータフローはプロセスを経由していますか?
- データストアに対する矢印の方向は正しいですか?
- レベル 1 の図は複雑すぎませんか?
- フィードバックループとエラーパスが含まれていますか?
- 文書全体で名称は統一されていますか?
これらの原則に従うことで、データフロー図が正確で信頼性があり、システムアーキテクチャのための有用なツールであることが保証されます。これらの一般的な落とし穴に対して、自分の作業を見直す時間を取ってください。