

Datenflussdiagramme bilden das Rückgrat der Systemanalyse und -gestaltung. Sie zeigen auf, wie Informationen durch ein System fließen, und heben Prozesse, Datenspeicher und externe Interaktionen hervor. Ein gut konstruiertes DFD klärt komplexe Logik sowohl für Entwickler als auch für alle Beteiligten. Die Erstellung eines genauen Diagramms erfordert jedoch Disziplin. Viele Analysten geraten in spezifische Fallstricke, die die Integrität des Modells gefährden.
Das Verständnis dieser Fallstricke ist entscheidend für die Aufrechterhaltung der Systemzuverlässigkeit. Dieser Leitfaden beschreibt sieben häufige Fehler und wie man sie effektiv korrigiert. Wir werden die theoretischen Auswirkungen jedes Fehlers untersuchen und praktische Hinweise zur Verbesserung geben.
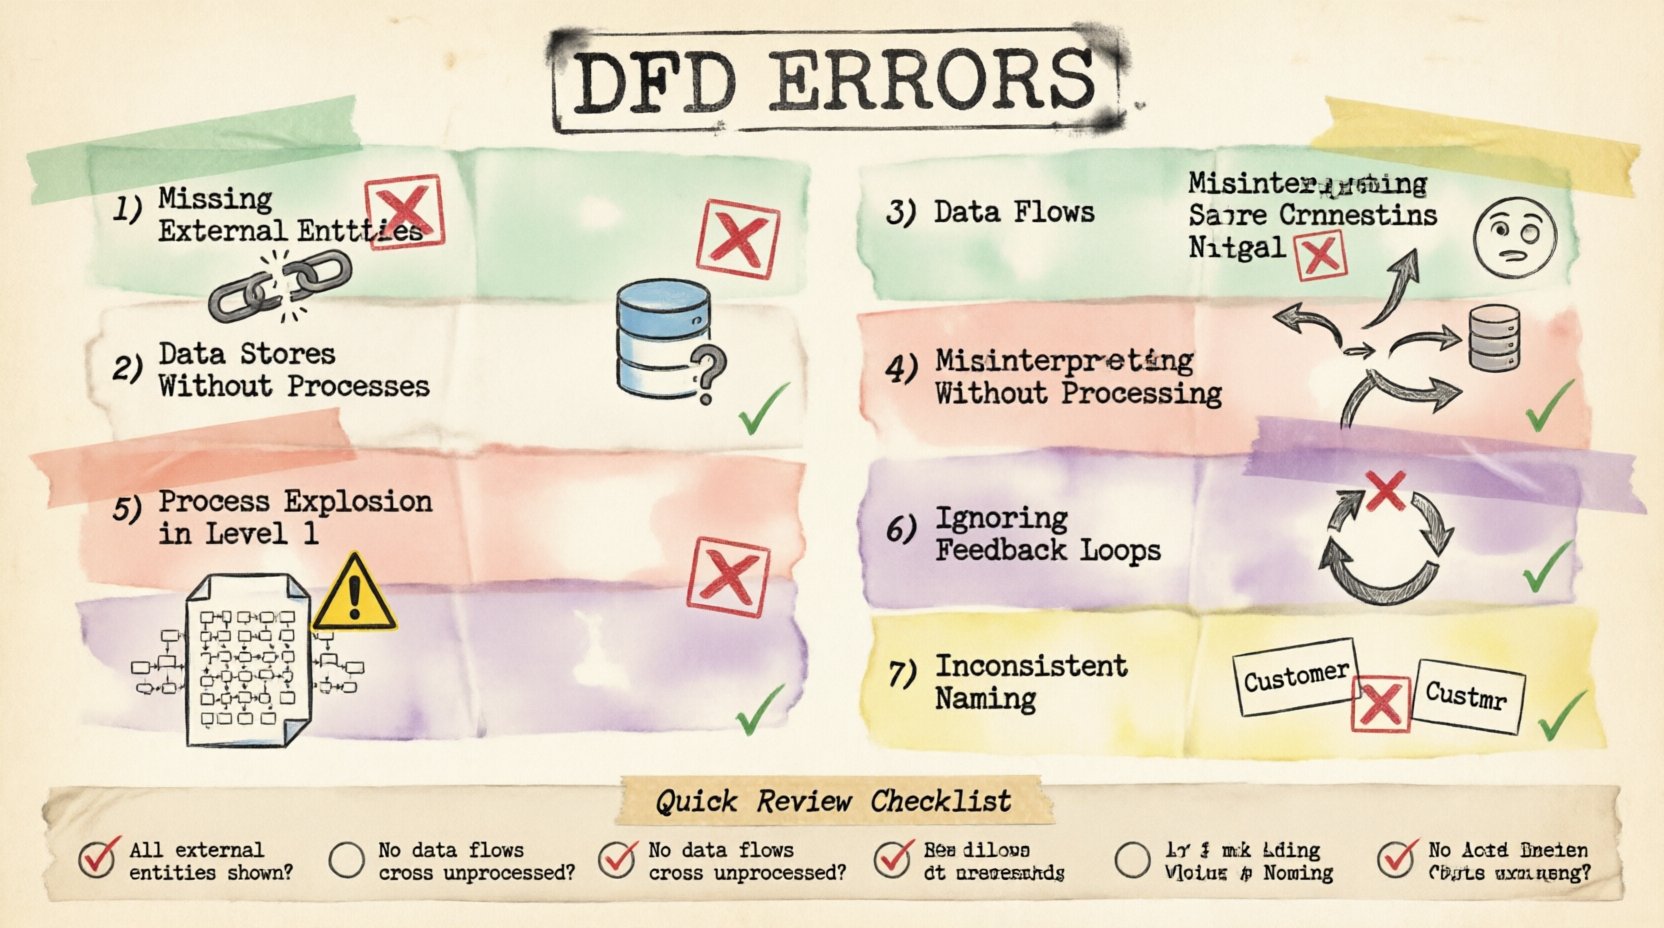
1. Fehlende externe Entitäten 🚫
Einer der grundlegendsten Fehler besteht darin, externe Entitäten wegzulassen. Externe Entitäten stellen Quellen oder Ziele von Daten außerhalb der Systemgrenze dar. Dies können Benutzer, andere Systeme oder Organisationen sein. Wenn ein DFD nicht zeigt, woher Daten stammen oder wohin sie letztendlich fließen, wird das Diagramm unvollständig.
Betrachten Sie ein Transaktionssystem. Wenn das Diagramm die Berechnung der Steuer zeigt, aber nicht die Übermittlung der Bestellung durch den Kunden, ist der Fluss unterbrochen. Ebenso muss, wenn das System eine Bestätigungs-E-Mail sendet, der E-Mail-Server als externe Entität dargestellt werden oder zumindest die Aktion mit einem klaren Ausgang verknüpft sein. Ohne diese Grenzen bleibt der Umfang des Systems unklar.
- Auswirkung:Entwickler können Prozesse erstellen, die auf Daten warten, die niemals eintreffen.
- Korrektur:Identifizieren Sie jeden Akteur oder jedes System, das mit der Software interagiert.
- Visueller Hinweis:Verwenden Sie Rechtecke, um Entitäten klar zu kennzeichnen.
Überprüfen Sie stets, dass jeder Datenfluss einen Start- und einen Endpunkt hat. Eine Linie in einem Diagramm kann nicht einfach im leeren Raum enden. Sie muss mit einem Prozess, einem Datenspeicher oder einer externen Entität verbunden sein.
2. Datenspeicher ohne Prozesse 🗄️
Datenspeicher stellen den permanenten Speicher dar. Sie halten Informationen für eine spätere Abrufung bereit. Ein kritischer Fehler tritt auf, wenn ein Datenspeicher existiert, ohne dass Prozesse darauf zugreifen oder Daten darin speichern. Dies erzeugt ein „Schwarzes Loch” oder ein unzugängliches Archiv innerhalb des Modells.
Wenn eine Datenbanktabelle im Diagramm definiert ist, aber kein Prozess gezeigt wird, der sie aktualisiert, ist dieser Speicher logisch getrennt. Umgekehrt, wenn ein Prozess in einen Speicher schreibt, aber nichts ihn jemals liest, dient die Daten keinem Zweck. Dies geschieht oft, wenn sich Analysten auf die Benutzeroberfläche konzentrieren und die Backend-Persistenzschicht vergessen.
Um dies zu beheben, verfolgen Sie jeden Datenspeicher. Stellen Sie sicher, dass es mindestens einen eingehenden und einen ausgehenden Datenfluss gibt. Dies stellt sicher, dass die Daten sowohl erstellt als auch genutzt werden. Es validiert den Lebenszyklus der Informationen innerhalb der Systemarchitektur.
3. Datenflüsse, die ohne Verarbeitung kreuzen 🔄
Datenflüsse sollten nur mit Prozessen verbunden sein. Ein häufiger Fehler besteht darin, eine Linie von einem Datenspeicher direkt zu einem anderen oder von einer externen Entität direkt zu einer anderen zu zeichnen und dabei die Verarbeitungslogik zu umgehen.
In einem gültigen DFD muss Daten transformiert werden. Wenn Daten von einer Quelle zu einem Ziel bewegt werden, muss etwas darauf einwirken. Ein Prozess stellt diese Transformation dar. Wenn Daten direkt zwischen zwei Speichern fließen, impliziert dies eine automatische Synchronisierung ohne Logik, was in komplexen Systemen selten zutrifft.
| Falscher Fluss | Korrekter Fluss |
|---|---|
| Entität → Datenspeicher | Entität → Prozess → Datenspeicher |
| Datenspeicher → Datenspeicher | Datenspeicher → Prozess → Datenspeicher |
| Entität → Entität | Entität → Prozess → Entität |
Die Sicherstellung, dass jeder Pfeil durch eine Prozessbox verläuft, erhält die logische Integrität des Modells. Sie zwingt den Analysten dazu zu definieren, was mit den Daten während des Transports passiert.
4. Fehlinterpretation von Verbindungen zu Datenspeichern 📉
Eine weitere Nuance betrifft die Richtung des Datenflusses im Verhältnis zu Datenspeichern. Ein Prozess kann in einen Speicher schreiben und daraus lesen. Analysten verwechseln jedoch oft die Richtung des Pfeils. Der Pfeil sollte auf den Speicher zeigen, wenn Daten geschrieben werden, und vom Speicher weg, wenn Daten gelesen werden.
Das Umkehren dieser Pfeile erzeugt Verwirrung über den Zustand des Systems. Speichert der Prozess das Ergebnis oder ruft er es ab? Eine klare Notation ist entscheidend. Einige Methoden erfordern unterschiedliche Notationen für Lese- und Schreibvorgänge, aber Konsistenz ist die Hauptanforderung, unabhängig vom verwendeten Standard.
Überprüfen Sie jede Verbindung zu einem Datenspeicher. Kennzeichnen Sie den Fluss bei Bedarf, um den Vorgang zu verdeutlichen. Zum Beispiel „Datensatz aktualisieren” oder „Kontostand abrufen”. Dies reduziert Mehrdeutigkeiten während der Entwicklungsphase.
5. Prozessexplosion in Level-1-Diagrammen 🧩
DFDs sind hierarchisch aufgebaut. Ein Kontextdiagramm zeigt das System als einen einzigen Prozess. Level 0 zerlegt dies in große Teilprozesse. Level 1 zerlegt diese Teilprozesse weiter. Ein häufiger Fehler besteht darin, zu viele Details in Level 1 aufzunehmen.
Wenn ein Level-1-Diagramm mit Dutzenden kleiner Prozesse überladen wird, verliert es seinen Wert als hochlevelige Karte. Es wird zu einem Flussdiagramm anstatt zu einem Datenflussdiagramm. Der Zweck von Level 1 besteht darin, die großen funktionalen Module zu zeigen, nicht jede einzelne Berechnung.
Wenn eine Prozessbox mehr als fünf bis sieben Teilprozesse enthält, sollte sie in ein separates Diagramm zerlegt werden. Dies hält die visuelle Hierarchie sauber. Es ermöglicht dem Betrachter, die Struktur des Systems zu verstehen, ohne sich in Details zu verlieren.
- Faustregel:Wenn Sie das Diagramm auf einer einzigen Standardseite ohne Scrollen zeichnen können, ist es wahrscheinlich angemessen.
- Ziel:Balanceieren Sie Detailtiefe und Lesbarkeit.
6. Ignorieren von Rückkopplungsschleifen und Steuerungsdaten 🔄
Systeme sind selten linear. Sie benötigen häufig Rückkopplungen, um das Verhalten anzupassen. Ein häufiger Fehler besteht darin, Steuerungsflüsse oder Rückkopplungsschleifen nicht zu diagrammieren. Beispielsweise kann ein Benutzer eine Fehlermeldung erhalten und Daten erneut eingeben. Diese Schleife muss sichtbar sein.
Wenn das Diagramm eine gerade Linie von der Eingabe zur Ausgabe zeigt, impliziert dies eine Einbahnstraße. Echte Systeme beinhalten Validierung, Ablehnung und Neubearbeitung. Das Ignorieren dieser Schleifen führt zu Systemen, die bei Fehlern abstürzen oder unvorhersehbar reagieren.
Fügen Sie den Pfad hinzu, über den Daten zur Korrektur zurückgesendet werden. Zeigen Sie den Prozess, der die Eingabe validiert. Zeigen Sie den Prozess, der die Ausnahme behandelt. Dies erstellt ein robustes Modell, das reale Nutzungsszenarien berücksichtigt.
7. Inkonsistente Benennungskonventionen 📝
Klarheit hängt von einer konsistenten Sprache ab. Die Verwendung von „Benutzer” in einem Teil des Diagramms und „Kunde” in einem anderen verwirrt den Leser. Ebenso deutet ein Prozess namens „Daten abrufen” neben einem Prozess namens „Informationen abrufen” darauf hin, dass sie möglicherweise unterschiedliche Dinge tun.
Standardisieren Sie Ihre Terminologie. Erstellen Sie ein Glossar für das Projekt und halten Sie sich daran. Datenflüsse sollten mit einem Substantiv benannt werden (z. B. „Bestelldetails
Auswirkung von Fehlern auf das Systemdesign 📊
Warum ist dieses Maß an Präzision wichtig? Fehler in DFDs wirken sich wellenförmig auf den gesamten Softwareentwicklungslebenszyklus aus. Eine fehlende Entität kann zu einem fehlenden API-Endpunkt führen. Ein unterbrochener Datenfluss kann in der Produktion zu einer Nullzeiger-Ausnahme führen.
Darüber hinaus wird die Wartung schwierig. Wenn die Dokumentation nicht mit dem Code übereinstimmt, werden zukünftige Ingenieure mehr Zeit mit Raten als mit dem Bauen verbringen. Die Korrektur eines DFD-Fehlers frühzeitig ist deutlich günstiger als die Behebung eines implementierten Fehlers.
Überprüfungstabelle ✅
Gehen Sie vor der endgültigen Fertigstellung Ihres Diagramms diese Überprüfungstabelle durch:
- Sind alle externen Entitäten definiert und beschriftet?
- Hat jeder Datenspeicher Lese- und Schreibzugriff?
- Durchlaufen alle Datenflüsse einen Prozess?
- Sind die Pfeilrichtungen für Datenspeicher korrekt?
- Ist das Level-1-Diagramm nicht zu komplex?
- Sind Rückkopplungsschleifen und Fehlerpfade enthalten?
- Sind die Bezeichnungen im gesamten Dokument konsistent?
Die Einhaltung dieser Prinzipien stellt sicher, dass Ihre Datenflussdiagramme präzise, zuverlässige und nützliche Werkzeuge für die Systemarchitektur sind. Nehmen Sie sich die Zeit, Ihre Arbeit gegen diese häufigen Fallstricke zu überprüfen.