

Diagramy przepływu danych stanowią fundament analizy i projektowania systemów. Mapują one sposób przemieszczania się informacji w systemie, wskazując procesy, magazyny danych oraz interakcje zewnętrzne. Starannie skonstruowany DFD wyjaśnia złożoną logikę zarówno programistom, jak i interesariuszom. Jednakże tworzenie dokładnego diagramu wymaga dyscypliny. Wielu analityków wpada w pułapki, które naruszają integralność modelu.
Zrozumienie tych pułapek jest kluczowe dla utrzymania niezawodności systemu. Niniejszy przewodnik szczegółowo opisuje siedem częstych błędów i sposób ich skutecznej korekty. Przeanalizujemy teoretyczne implikacje każdego błędu i przedstawimy praktyczne wskazówki dotyczące poprawy.
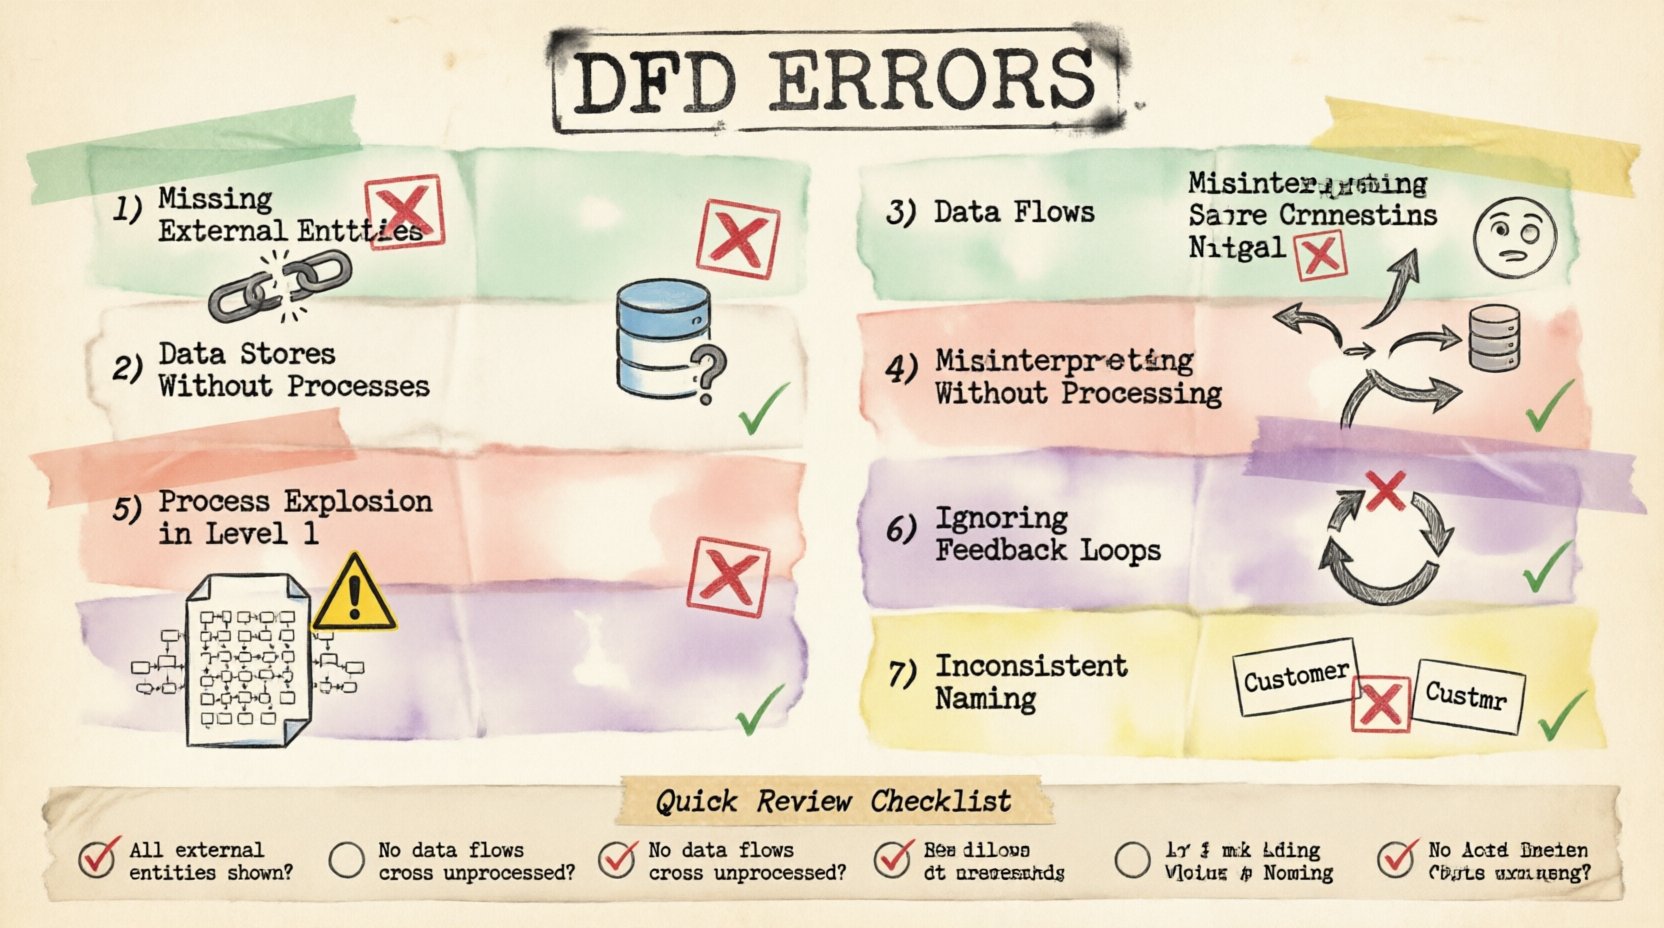
1. Brakujące podmioty zewnętrzne 🚫
Jednym z najbardziej fundamentalnych błędów jest pomijanie podmiotów zewnętrznych. Podmioty zewnętrzne reprezentują źródła lub miejsca przeznaczenia danych spoza granic systemu. Mogą to być użytkownicy, inne systemy lub organizacje. Gdy DFD nie pokazuje, skąd pochodzą dane lub gdzie ostatecznie trafiają, diagram staje się niekompletny.
Rozważmy system przetwarzania transakcji. Jeśli diagram przedstawia obliczanie podatku, ale nie pokazuje klienta składającego zamówienie, przepływ jest przerwany. Podobnie, jeśli system wysyła e-mail potwierdzający, serwer pocztowy musi być przedstawiony jako podmiot zewnętrzny, lub przynajmniej czynność musi być powiązana z wyraźnym wyjściem. Bez tych granic zakres systemu pozostaje niejasny.
- Skutek:Programiści mogą tworzyć procesy oczekujące na dane, które nigdy nie przybędą.
- Korekta:Zidentyfikuj każdego aktora lub system oddziałujący z oprogramowaniem.
- Wskazówka wizualna:Używaj prostokątów do wyraźnego oznaczania podmiotów.
Zawsze sprawdzaj, czy każdy przepływ danych ma punkt początkowy i końcowy. Linia na diagramie nie może po prostu kończyć się w pustej przestrzeni. Musi ona łączyć się z procesem, magazynem danych lub podmiotem zewnętrznym.
2. Magazyny danych bez procesów 🗄️
Magazyny danych reprezentują trwałe przechowywanie. Przechowują one informacje do późniejszego pobrania. Krytyczny błąd występuje, gdy magazyn danych istnieje bez żadnych procesów odczytujących z niego lub zapisujących do niego. Tworzy to „czarną dziurę” lub niedostępny archiwum w modelu.
Jeśli tabela w bazie danych jest zdefiniowana na diagramie, ale nie pokazano żadnego procesu aktualizującego ją, to przechowywanie jest logicznie odłączone. Z drugiej strony, jeśli proces zapisuje dane do magazynu, ale nic z niego nigdy nie odczytuje, dane nie pełnią żadnej funkcji. Dzieje się tak często, gdy analitycy skupiają się na interfejsie użytkownika i zapominają o warstwie trwałego przechowywania w backendzie.
Aby to naprawić, prześledź każdy magazyn danych. Upewnij się, że istnieje co najmniej jeden przepływ przychodzący i jeden wychodzący. Gwarantuje to, że dane są zarówno tworzone, jak i wykorzystywane. Waliduje to cykl życia informacji w architekturze systemu.
3. Przepływy danych krzyżujące się bez przetwarzania 🔄
Przepływy danych powinny łączyć się wyłącznie z procesami. Pospolitym błędem jest rysowanie linii od jednego magazynu danych bezpośrednio do drugiego lub od podmiotu zewnętrznego bezpośrednio do innego podmiotu, pomijając logikę przetwarzania.
W poprawnym DFD dane muszą być transformowane. Gdy dane przemieszczają się ze źródła do celu, coś musi na nie działać. Proces reprezentuje tę transformację. Jeśli dane przepływają bezpośrednio między dwoma magazynami, sugeruje to automatyczną synchronizację bez logiki, co w złożonych systemach jest rzadko prawdziwe.
| Nieprawidłowy przepływ | Poprawny przepływ |
|---|---|
| Podmiot → Magazyn danych | Podmiot → Proces → Magazyn danych |
| Magazyn danych → Magazyn danych | Magazyn danych → Proces → Magazyn danych |
| Podmiot → Podmiot | Podmiot → Proces → Podmiot |
Upewnienie się, że każda strzałka przechodzi przez pole procesu, zachowuje logiczną integralność modelu. Zmusza to analityka do zdefiniowania tego, co dzieje się z danymi w trakcie ich przemieszczania.
4. Niezrozumienie połączeń magazynów danych 📉
Kolejny niuans dotyczy kierunku przepływu danych względem magazynów danych. Proces może zapisywać dane do magazynu i odczytywać z niego. Jednak analitycy często mylą kierunek strzałki. Strzałka powinna wskazywać w stronę magazynu, gdy dane są zapisywane, i od magazynu, gdy dane są odczytywane.
Odwrócenie tych strzałek powoduje zamieszanie co do stanu systemu. Czy proces przechowuje wynik, czy też pobiera wynik? Jasna notacja jest kluczowa. Niektóre metody wymagają odrębnych notacji dla operacji odczytu i zapisu, ale spójność jest głównym wymogiem niezależnie od używanego standardu.
Przejrzyj każde połączenie z magazynem danych. Oznacz przepływ, jeśli to konieczne, aby wyjaśnić operację. Na przykład: „Aktualizuj rekord” lub „Pobierz saldo”. Zmniejsza to niejednoznaczność w fazie rozwoju.
5. Wybuch procesów na diagramach poziomu 1 🧩
Diagramy przepływu danych są hierarchiczne. Diagram kontekstowy przedstawia system jako pojedynczy proces. Poziom 0 rozkłada go na główne podprocesy. Poziom 1 dalej dekomponuje te podprocesy. Częstym błędem jest umieszczanie zbyt wielu szczegółów na poziomie 1.
Gdy diagram poziomu 1 staje się przeładowany dziesiątkami drobnych procesów, traci swoją wartość jako mapa wysokiego poziomu. Zamienia się w schemat blokowy, a nie w diagram przepływu danych. Celem poziomu 1 jest pokazanie głównych modułów funkcjonalnych, a nie każdego pojedynczego obliczenia.
Jeśli pole procesu zawiera więcej niż pięć do siedmiu podprocesów, powinno ono zostać wyodrębnione do osobnego diagramu. Utrzymuje to czystość hierarchii wizualnej. Pozwala to odbiorcy zrozumieć strukturę systemu bez zagubienia się w szczegółach.
- Zasada kciuka:Jeśli możesz narysować diagram na jednej standardowej stronie bez przewijania, prawdopodobnie jest on odpowiedni.
- Cel:Zbalansuj szczegółowość z czytelnością.
6. Ignorowanie pętli sprzężenia zwrotnego i danych sterujących 🔄
Systemy rzadko są liniowe. Często wymagają sprzężenia zwrotnego do dostosowania zachowania. Pospolitym błędem jest pomijanie diagramowania przepływów sterujących lub pętli sprzężenia zwrotnego. Na przykład użytkownik może otrzymać komunikat o błędzie i ponownie wprowadzić dane. Ta pętla musi być widoczna.
Jeśli diagram przedstawia prostą linię od wejścia do wyjścia, sugeruje to podróż w jedną stronę. Rzeczywiste systemy obejmują walidację, odrzucenie i ponowne przetwarzanie. Ignorowanie tych pętli prowadzi do systemów, które zawieszają się lub zachowują się nieprzewidywalnie w przypadku wystąpienia błędów.
Dołącz ścieżkę, na której dane są zwracane w celu poprawy. Pokaż proces walidujący dane wejściowe. Pokaż proces obsługujący wyjątek. Tworzy to solidny model uwzględniający scenariusze rzeczywistego użytkowania.
7. Niezgodne konwencje nazewnictwa 📝
Jasność zależy od spójnego języka. Używanie „Użytkownik” w jednej części diagramu i „Klient” w innej wprowadza czytelnika w błąd. Podobnie proces nazwany „Pobierz dane” obok procesu nazwanego „Pobierz informacje” sugeruje, że mogą one wykonywać różne zadania.
Standaryzuj swoją terminologię. Stwórz słownik dla projektu i się go trzymaj. Przepływy danych powinny być nazwane rzeczownikiem (np. „Szczegóły zamówienia”), podczas gdy procesy powinny być nazwane połączeniem czasownika z rzeczownikiem (np. „Oblicz całkowitą kwotę”).
Spójność ułatwia komunikację. Gdy programiści czytają diagram, nie powinni muszgadnąć, co oznacza dany termin. Zmniejsza to ryzyko nieporozumień i konieczności poprawek na późniejszym etapie cyklu rozwoju.
Wpływ błędów na projektowanie systemu 📊
Dlaczego ten poziom precyzji ma znaczenie? Błędy w diagramach przepływu danych (DFD) rozchodzą się po całym cyklu życia oprogramowania. Brakująca encja może skutkować brakiem punktu końcowego API. Przerwany przepływ danych może prowadzić do wyjątku null pointer w środowisku produkcyjnym.
Co więcej, utrzymanie staje się trudne. Jeśli dokumentacja nie odpowiada kodowi, przyszli inżynierowie spędzą więcej czasu na zgadywanie niż na budowanie. Poprawienie błędu w DFD na wczesnym etapie jest znacznie tańsze niż naprawianie wdrożonego błędu.
Lista kontrolna przeglądu ✅
Przed finalizacją diagramu przejdź przez tę listę weryfikacyjną:
- Czy wszystkie encje zewnętrzne zostały zdefiniowane i oznaczone?
- Czy każdy magazyn danych ma dostęp do odczytu i zapisu?
- Czy wszystkie przepływy danych przechodzą przez proces?
- Czy kierunki strzałek są poprawne dla magazynów danych?
- Czy diagram poziomu 1 nie jest zbyt skomplikowany?
- Czy uwzględniono pętle sprzężenia zwrotnego i ścieżki błędów?
- Czy nazwy są spójne w całym dokumencie?
Przestrzeganie tych zasad zapewnia, że Twoje diagramy przepływu danych są dokładne, niezawodne i użyteczne narzędzia do architektury systemu. Poświęć czas na sprawdzenie swojej pracy pod kątem tych powszechnych błędów.