

डेटा फ्लो डायग्राम (DFD) सिस्टम विश्लेषण और डिजाइन की रीढ़ की हड्डी का काम करते हैं। ये यह दर्शाते हैं कि जानकारी एक सिस्टम के माध्यम से कैसे प्रवाहित होती है, जिसमें प्रक्रियाएं, डेटा स्टोरेज और बाहरी इंटरैक्शन पर जोर दिया जाता है। एक अच्छी तरह से बनाया गया DFD डेवलपर्स और हितधारकों दोनों के लिए जटिल तर्क को स्पष्ट करता है। हालांकि, एक सटीक डायग्राम बनाने के लिए अनुशासन की आवश्यकता होती है। कई विश्लेषक ऐसे फंदों में फंस जाते हैं जो मॉडल की अखंडता को कमजोर करते हैं।
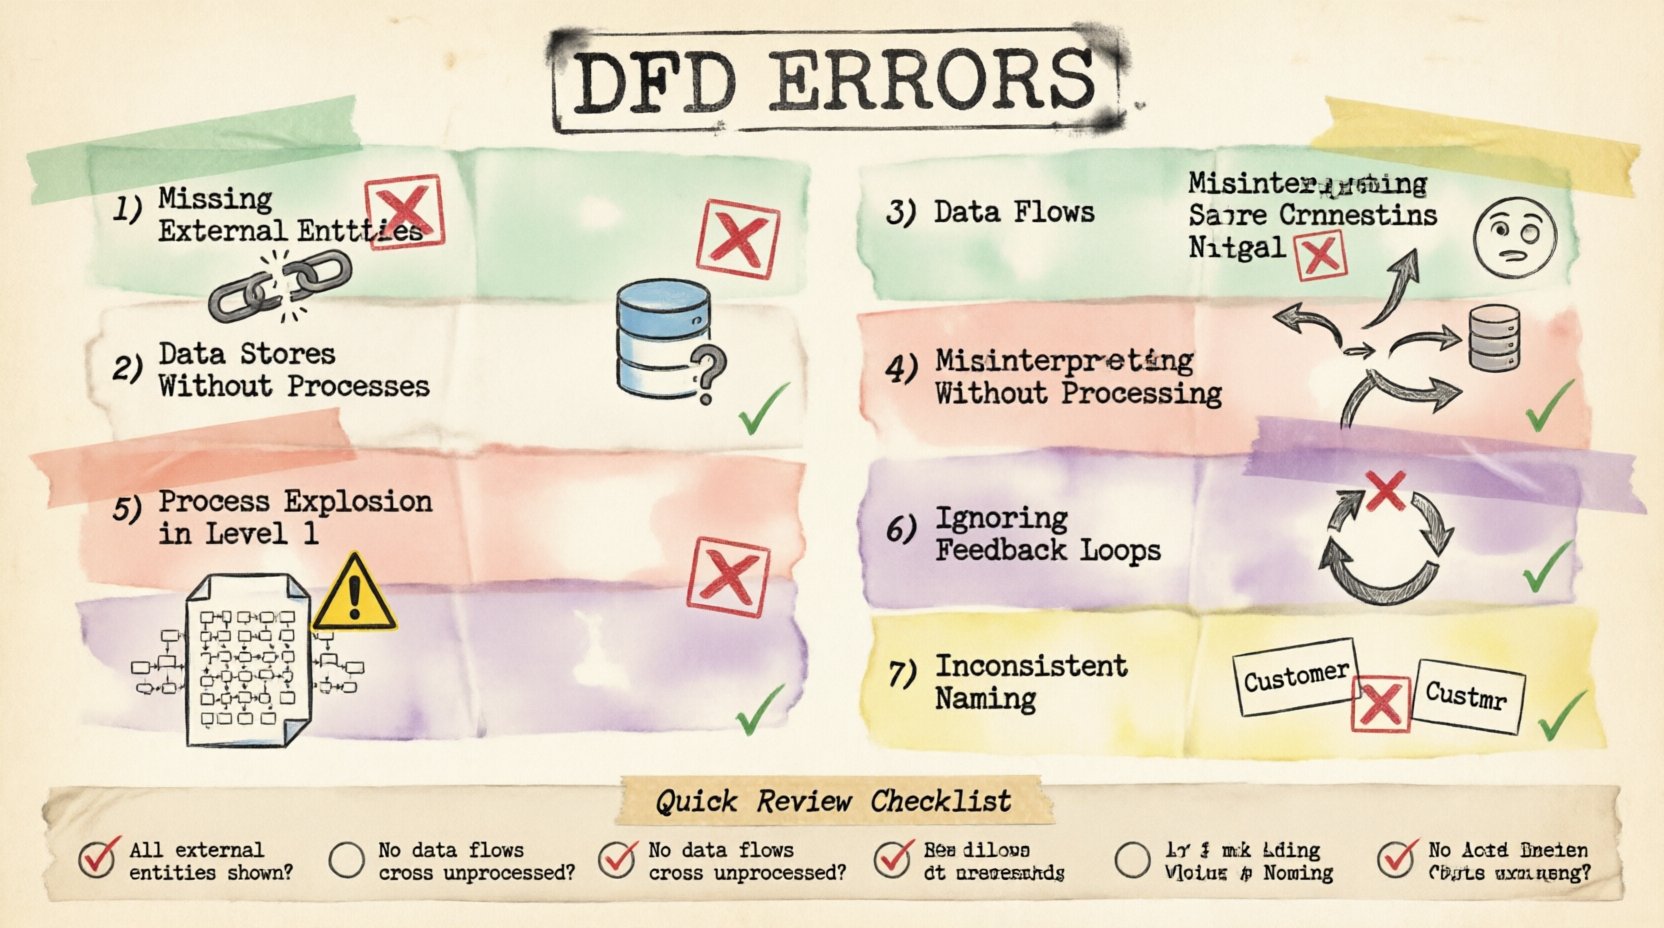
इन गलतियों को समझना सिस्टम की विश्वसनीयता बनाए रखने के लिए आवश्यक है। यह गाइड सात बार-बार होने वाली गलतियों और उन्हें प्रभावी ढंग से कैसे सुधारा जाए, इसका विस्तार से वर्णन करती है। हम प्रत्येक गलती के सैद्धांतिक प्रभावों का पता लगाएंगे और सुधार के लिए व्यावहारिक मार्गदर्शन प्रदान करेंगे।
1. बाहरी इकाइयों का अभाव 🚫
सबसे मौलिक गलतियों में से एक बाहरी इकाइयों को छोड़ना है। बाहरी इकाइयाँ सिस्टम की सीमा के बाहर डेटा के स्रोतों या गंतव्यों का प्रतिनिधित्व करती हैं। ये उपयोगकर्ता, अन्य सिस्टम या संगठन हो सकते हैं। जब एक DFD यह नहीं दिखाता कि डेटा कहाँ से आता है या अंत में कहाँ जाता है, तो डायग्राम अधूरा हो जाता है।
एक लेनदेन प्रोसेसिंग सिस्टम का विचार करें। यदि डायग्राम में टैक्स की गणना दिखाई गई है लेकिन ग्राहक के ऑर्डर जमा करने की प्रक्रिया नहीं दिखाई गई है, तो प्रवाह टूट जाता है। इसी तरह, यदि सिस्टम एक पुष्टि ईमेल भेजता है, तो ईमेल सर्वर को एक बाहरी इकाई के रूप में दर्शाया जाना चाहिए या कम से कम उस क्रिया को एक स्पष्ट आउटपुट से जोड़ा जाना चाहिए। इन सीमाओं के बिना, सिस्टम की सीमा अस्पष्ट बनी रहती है।
- प्रभाव:डेवलपर्स ऐसे प्रक्रियाएं बना सकते हैं जो ऐसे डेटा की उम्मीद करती हैं जो कभी नहीं आता।
- सुधार:सॉफ्टवेयर के साथ इंटरैक्ट करने वाले प्रत्येक अभिनेता या सिस्टम की पहचान करें।
- दृश्य संकेत:इकाइयों को स्पष्ट रूप से दर्शाने के लिए आयत का उपयोग करें।
हमेशा सत्यापित करें कि प्रत्येक डेटा फ्लो का एक प्रारंभ और एक अंत बिंदु हो। डायग्राम में कोई रेखा खाली जगह में समाप्त नहीं हो सकती। इसे एक प्रक्रिया, डेटा स्टोरेज या बाहरी इकाई से जोड़ा जाना चाहिए।
2. प्रक्रियाओं के बिना डेटा स्टोरेज 🗄️
डेटा स्टोरेज स्थायी भंडारण का प्रतिनिधित्व करते हैं। वे बाद में पुनर्प्राप्ति के लिए जानकारी को संग्रहीत करते हैं। एक गंभीर गलती तब होती है जब कोई डेटा स्टोरेज बिना किसी प्रक्रिया के मौजूद होता है जो उससे पढ़ता या उसमें लिखता है। इससे मॉडल के भीतर एक ‘काला छिद्र’ या अगम्य आर्काइव बन जाता है।
यदि डायग्राम में एक डेटाबेस टेबल परिभाषित है लेकिन कोई प्रक्रिया इसे अपडेट करते हुए नहीं दिखाई गई है, तो वह भंडारण तार्किक रूप से अलग हो जाता है। इसके विपरीत, यदि कोई प्रक्रिया किसी स्टोरेज में लिखती है लेकिन कभी कोई उससे नहीं पढ़ता, तो डेटा का कोई उद्देश्य नहीं होता है। यह अक्सर तब होता है जब विश्लेषक उपयोगकर्ता इंटरफेस पर ध्यान केंद्रित करते हैं और बैकएंड पर्सिस्टेंस परत को भूल जाते हैं।
इसे ठीक करने के लिए, प्रत्येक डेटा स्टोरेज को ट्रैक करें। सुनिश्चित करें कि कम से कम एक इनकमिंग फ्लो और एक आउटगोइंग फ्लो हो। यह सुनिश्चित करता है कि डेटा बनाया भी गया है और उपयोग में भी लाया गया है। यह सिस्टम आर्किटेक्चर के भीतर जानकारी के जीवन चक्र की पुष्टि करता है।
3. प्रोसेसिंग के बिना डेटा फ्लो का क्रॉसिंग 🔄
डेटा फ्लो केवल प्रक्रियाओं से जुड़े होने चाहिए। एक सामान्य गलती एक डेटा स्टोरेज से सीधे दूसरे डेटा स्टोरेज तक या एक बाहरी इकाई से सीधे दूसरी इकाई तक रेखा खींचना है, जिससे प्रोसेसिंग तर्क को छोड़ दिया जाता है।
एक मान्य DFD में, डेटा को परिवर्तित किया जाना चाहिए। जब डेटा एक स्रोत से गंतव्य की ओर जाता है, तो कुछ भी उस पर कार्य करना चाहिए। एक प्रक्रिया इस परिवर्तन का प्रतिनिधित्व करती है। यदि डेटा दो स्टोरेज के बीच सीधे प्रवाहित होता है, तो इसका तात्पर्य तर्क के बिना स्वचालित सिंकनाइजेशन से है, जो जटिल सिस्टम में दुर्लभ रूप से सटीक होता है।
| गलत प्रवाह | सही प्रवाह |
|---|---|
| इकाई → डेटा स्टोरेज | इकाई → प्रक्रिया → डेटा स्टोरेज |
| डेटा स्टोरेज → डेटा स्टोरेज | डेटा स्टोरेज → प्रक्रिया → डेटा स्टोरेज |
| इकाई → इकाई | इकाई → प्रक्रिया → इकाई |
यह सुनिश्चित करना कि प्रत्येक तीर एक प्रक्रिया बॉक्स से होकर गुजरता है, मॉडल की तार्किक अखंडता को बनाए रखता है। यह विश्लेषक को यह परिभाषित करने पर मजबूर करता है कि प्रवाह के दौरान डेटा के साथ क्या होता है।
4. डेटा स्टोरेज कनेक्शन का गलत अर्थ 📉
एक अन्य सूक्ष्मता डेटा फ्लो की दिशा का संबंध डेटा स्टोरेज से है। एक प्रक्रिया किसी स्टोरेज में लिख सकती है और उससे पढ़ भी सकती है। हालांकि, विश्लेषक अक्सर तीर की दिशा में भ्रम करते हैं। जब डेटा लिखा जाता है, तो तीर स्टोरेज की ओर इशारा करना चाहिए और जब डेटा पढ़ा जाता है, तो तीर स्टोरेज से दूर इशारा करना चाहिए।
इन तीरों को उलटने से सिस्टम की स्थिति के बारे में भ्रम पैदा होता है। क्या प्रक्रिया परिणाम को संग्रहीत करती है, या क्या वह परिणाम को पुनर्प्राप्त करती है? स्पष्ट नोटेशन अत्यंत महत्वपूर्ण है। कुछ विधियों में पढ़ने और लिखने की क्रियाओं के लिए अलग-अलग नोटेशन की आवश्यकता होती है, लेकिन विशिष्ट मानक का उपयोग करने पर निर्वाप, संगति ही मुख्य आवश्यकता है।
डेटा स्टोरेज से हर कनेक्शन की समीक्षा करें। यदि आवश्यक हो तो क्रिया को स्पष्ट करने के लिए फ्लो को लेबल करें। उदाहरण के लिए, “रिकॉर्ड अपडेट करें” या “बैलेंस लें”। इससे विकास चरण में अस्पष्टता कम होती है।
5. लेवल 1 डायग्राम में प्रक्रियाओं का विस्फोट 🧩
DFD पदानुक्रमित होते हैं। एक संदर्भ डायग्राम (Context Diagram) सिस्टम को एकल प्रक्रिया के रूप में दर्शाता है। लेवल 0 इसे मुख्य उप-प्रक्रियाओं में तोड़ता है। लेवल 1 उन उप-प्रक्रियाओं को और विघटित करता है। एक बार-बार होने वाली गलती लेवल 1 में बहुत अधिक विवरण डालना है।
जब एक लेवल 1 डायग्राम दर्जनों छोटी प्रक्रियाओं से भिड़ जाता है, तो यह उच्च-स्तरीय मानचित्र के रूप में अपना मूल्य खो देता है। यह एक डेटा फ्लो डायग्राम के बजाय एक फ्लोचार्ट बन जाता है। लेवल 1 का उद्देश्य प्रत्येक व्यक्तिगत गणना नहीं, बल्कि मुख्य कार्यात्मक मॉड्यूल को दिखाना है।
यदि एक प्रक्रिया बॉक्स में पांच से सात से अधिक उप-प्रक्रियाएं हैं, तो उसे एक अलग डायग्राम में विघटित किया जाना चाहिए। इससे दृश्य पदानुक्रम साफ रहता है। यह दर्शक को सिस्टम की संरचना को समझने की अनुमति देता है बिना कि वह विस्तार में खो जाए।
- अनुमान का नियम:यदि आप बिना स्क्रॉल किए एकल मानक पेज पर डायग्राम बना सकते हैं, तो यह संभवतः उचित है।
- लक्ष्य: विस्तार और पठनीयता के बीच संतुलन बनाएं।
6. फीडबैक लूप और नियंत्रण डेटा को नजरअंदाज करना 🔄
सिस्टम दुर्लभ रूप से रैखिक होते हैं। वे व्यवहार को समायोजित करने के लिए अक्सर फीडबैक की आवश्यकता होती है। एक सामान्य गलती नियंत्रण प्रवाह या फीडबैक लूप को डायग्राम करने में विफल होना है। उदाहरण के लिए, एक उपयोगकर्ता को त्रुटि संदेश प्राप्त हो सकता है और उसे डेटा को पुनः दर्ज करना पड़ सकता है। यह लूप स्पष्ट रूप से दिखाई देना चाहिए।
यदि डायग्राम इनपुट से आउटपुट तक एक सीधी रेखा दिखाता है, तो इसका अर्थ है कि यह एक एकतरफा यात्रा है। वास्तविक सिस्टम में मान्यकरण, अस्वीकृति और पुनः प्रसंस्करण शामिल होता है। इन लूपों को नजरअंदाज करने से सिस्टम तब क्रैश हो जाते हैं या अनिश्चित व्यवहार करते हैं जब त्रुटियां होती हैं।
उस पथ को शामिल करें जहां डेटा सुधार के लिए वापस भेजा जाता है। इनपुट को मान्य करने वाली प्रक्रिया को दिखाएं। अपवाद को संभालने वाली प्रक्रिया को दिखाएं। यह एक मजबूत मॉडल बनाता है जो वास्तविक दुनिया के उपयोग परिदृश्यों को ध्यान में रखता है।
7. असंगत नामकरण परंपराएं 📝
स्पष्टता संगत भाषा पर निर्भर करती है। डायग्राम के एक हिस्से में “उपयोगकर्ता” और दूसरे हिस्से में “ग्राहक” का उपयोग करने से पाठक भ्रमित हो जाता है। इसी तरह, “Get Data” नामक प्रक्रिया के बगल में “Retrieve Information” नामक प्रक्रिया यह सुझाव देती है कि वे अलग-अलग काम कर सकते हैं।
अपनी शब्दावली को मानकीकृत करें। परियोजना के लिए एक शब्दावली बनाएं और उस पर अमल करें। डेटा प्रवाहों को एक संज्ञा (उदाहरण के लिए, “ऑर्डर विवरण”) के साथ नामित किया जाना चाहिए, जबकि प्रक्रियाओं को क्रिया-संज्ञा संयोजन (उदाहरण के लिए, “कुल गणना करें”) के साथ नामित किया जाना चाहिए।
संगति संचार में सहायता करती है। जब डेवलपर डायग्राम को पढ़ते हैं, तो उन्हें किसी शब्द का अर्थ अनुमानित नहीं करना चाहिए। इससे विकास चक्र के बाद में गलत व्याख्या और पुनः कार्य करने के जोखिम को कम किया जाता है।
सिस्टम डिजाइन पर त्रुटियों का प्रभाव 📊
इस स्तर की सटीकता क्यों महत्वपूर्ण है? DFD में त्रुटियां पूरे सॉफ्टवेयर विकास जीवन चक्र में फैलती हैं। एक अनुपस्थित इकाई एक अनुपस्थित API एंडपॉइंट का कारण बन सकती है। एक टूटा हुआ डेटा प्रवाह उत्पादन में नल पॉइंटर अपवाद का कारण बन सकता है।
इसके अलावा, रखरखाव कठिन हो जाता है। यदि दस्तावेज़ीकरण कोड से मेल नहीं खाता है, तो भविष्य के इंजीनियर निर्माण करने की तुलना में अधिक समय अनुमान लगाने में बिताएंगे। DFD में गलती को शुरुआत में सुधारना किसी डिप्लॉय किए गए बग को ठीक करने की तुलना में काफी सस्ता है।
रीविज़न चेकलिस्ट ✅
अपना डायग्राम अंतिम रूप देने से पहले, इस सत्यापन सूची को एक बार देखें:
- क्या सभी बाहरी इकाइयां परिभाषित और लेबल की गई हैं?
- क्या प्रत्येक डेटा भंडार में पढ़ने और लिखने की अनुमति है?
- क्या सभी डेटा प्रवाह एक प्रक्रिया से होकर गुजरते हैं?
- क्या डेटा भंडारों के लिए तीर की दिशा सही है?
- क्या लेवल 1 डायग्राम बहुत जटिल नहीं है?
- क्या फीडबैक लूप और त्रुटि पथ शामिल हैं?
- क्या दस्तावेज़ में नाम संपूर्ण रूप से संगत हैं?
इन सिद्धांतों का पालन करने से सुनिश्चित होता है कि आपके डेटा फ्लो डायग्राम सटीक, विश्वसनीय और सिस्टम आर्किटेक्चर के लिए उपयोगी उपकरण हैं। इन सामान्य गलतियों के खिलाफ अपने काम की समीक्षा करने के लिए समय निकालें।