

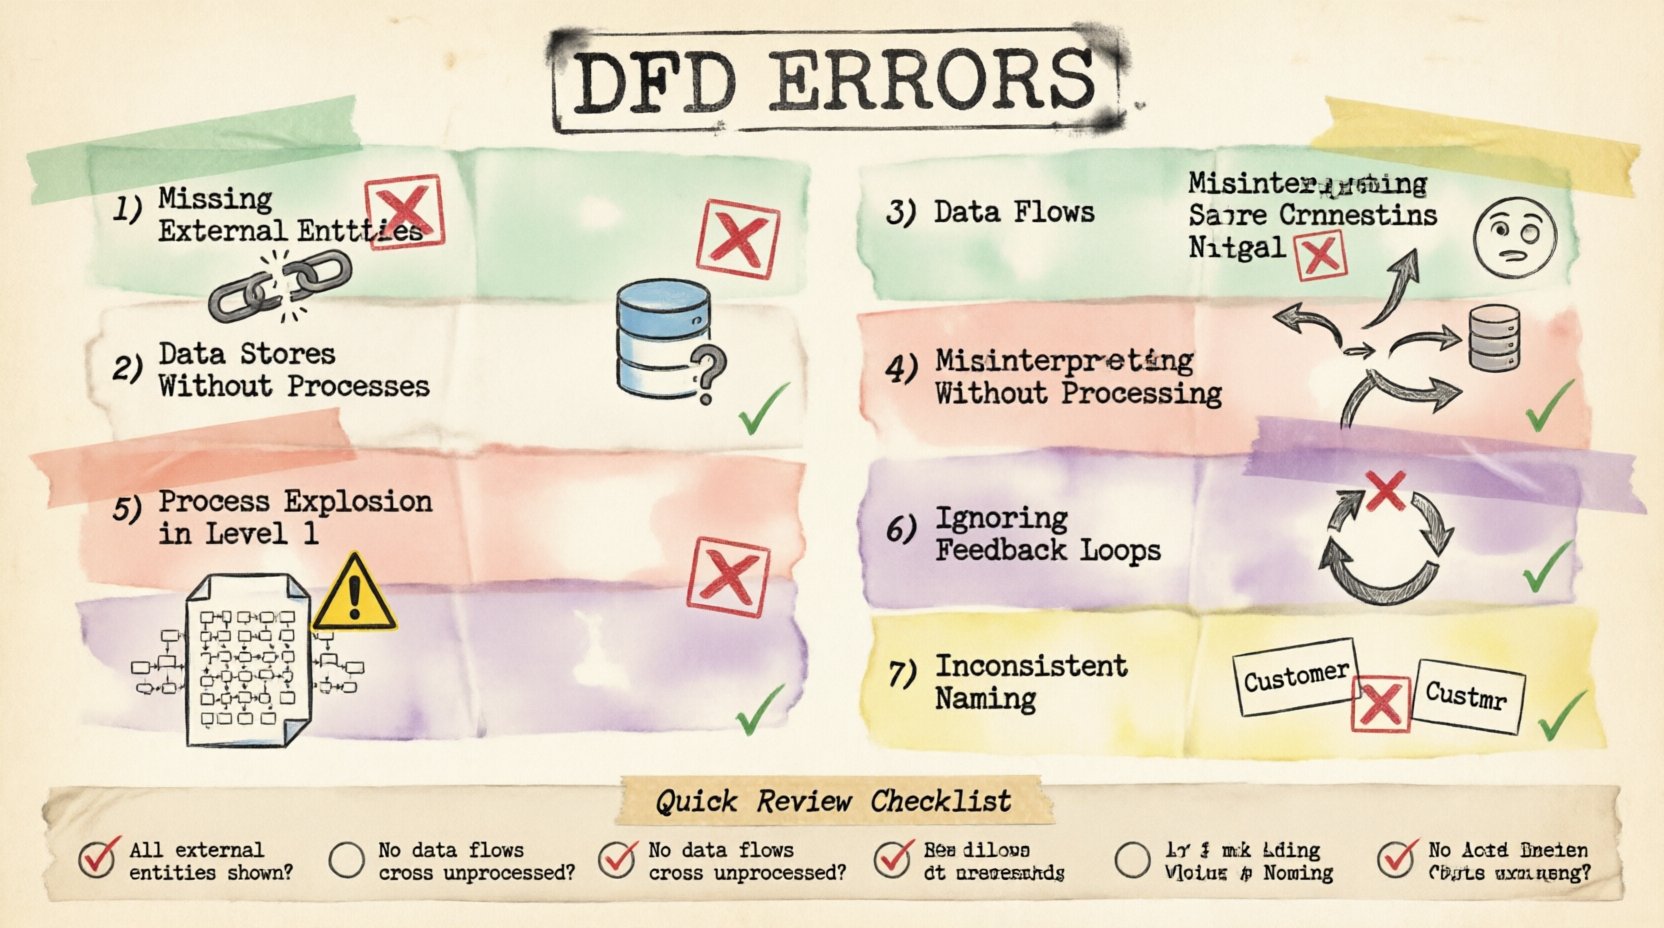
Диаграммы потоков данных (DFD) служат основой анализа и проектирования систем. Они отображают, как информация перемещается через систему, выделяя процессы, хранилища данных и внешние взаимодействия. Грамотно составленная DFD проясняет сложную логику как для разработчиков, так и для заинтересованных сторон. Однако создание точной диаграммы требует дисциплины. Многие аналитики попадают в специфические ловушки, которые подрывают целостность модели.
Понимание этих подводных камней необходимо для обеспечения надёжности системы. Данное руководство подробно описывает семь распространённых ошибок и способы их эффективного устранения. Мы рассмотрим теоретические последствия каждой ошибки и предоставим практические рекомендации по улучшению.
1. Отсутствие внешних сущностей 🚫
Одной из самых фундаментальных ошибок является пропуск внешних сущностей. Внешние сущности представляют собой источники или получатели данных за пределами границ системы. Это могут быть пользователи, другие системы или организации. Когда DFD не показывает, откуда берутся данные или куда они в конечном итоге поступают, диаграмма становится неполной.
Рассмотрим систему обработки транзакций. Если на диаграмме показан расчёт налога, но не показано, как клиент подаёт заказ, поток нарушен. Аналогично, если система отправляет подтверждение по электронной почте, сервер электронной почты должен быть представлен как внешняя сущность или, по крайней мере, действие должно быть связано с чётким выходным результатом. Без этих границ область действия системы остаётся неопределённой.
- Последствия:Разработчики могут создавать процессы, которые ожидают данные, которые никогда не поступают.
- Исправление:Определите каждого участника или систему, взаимодействующую с программным обеспечением.
- Визуальный ориентир:Используйте прямоугольники для чёткого обозначения сущностей.
Всегда проверяйте, чтобы каждый поток данных имел начальную и конечную точку. Линия на диаграмме не может просто обрываться в пустом пространстве. Она должна соединяться с процессом, хранилищем данных или внешней сущностью.
2. Хранилища данных без процессов 🗄️
Хранилища данных представляют собой постоянное хранилище. Они содержат информацию для последующего извлечения. Критическая ошибка возникает, когда хранилище данных существует без каких-либо процессов, читающих из него или записывающих в него. Это создаёт «чёрную дыру» или недостижимый архив внутри модели.
Если таблица базы данных определена на диаграмме, но не показан процесс, который её обновляет, это хранилище логически отключено. И наоборот, если процесс записывает данные в хранилище, но никто никогда не читает их оттуда, данные не имеют смысла. Это часто случается, когда аналитики фокусируются на пользовательском интерфейсе и забывают о слое персистентности бэкенда.
Чтобы исправить это, отследите каждое хранилище данных. Убедитесь, что есть хотя бы один входящий поток и один исходящий поток. Это гарантирует, что данные как создаются, так и используются. Это подтверждает жизненный цикл информации в архитектуре системы.
3. Потоки данных, пересекающиеся без обработки 🔄
Потоки данных должны соединяться только с процессами. Распространённая ошибка — рисовать линию от одного хранилища данных напрямую к другому или от внешней сущности напрямую к другой сущности, минуя логику обработки.
В корректной DFD данные должны преобразовываться. Когда данные перемещаются от источника к получателю, что-то должно действовать с ними. Процесс представляет это преобразование. Если данные протекают напрямую между двумя хранилищами, это подразумевает автоматическую синхронизацию без логики, что редко бывает точным в сложных системах.
| Неверный поток | Верный поток |
|---|---|
| Сущность → Хранилище данных | Сущность → Процесс → Хранилище данных |
| Хранилище данных → Хранилище данных | Хранилище данных → Процесс → Хранилище данных |
| Сущность → Сущность | Сущность → Процесс → Сущность |
Обеспечение того, чтобы каждая стрелка проходила через блок процесса, сохраняет логическую целостность модели. Это вынуждает аналитика определить, что происходит с данными во время передачи.
4. Неправильное толкование соединений хранилищ данных 📉
Другой нюанс касается направления потока данных относительно хранилищ данных. Процесс может записывать данные в хранилище и читать из него. Однако аналитики часто путают направление стрелки. Стрелка должна указывать на хранилище, когда данные записываются, и от хранилища, когда данные читаются.
Разворот этих стрелок создаёт путаницу относительно состояния системы. Сохраняет ли процесс результат или извлекает его? Чёткая нотация жизненно важна. Некоторые методологии требуют различных обозначений для операций чтения и записи, но согласованность является ключевым требованием независимо от используемого конкретного стандарта.
Проверьте каждое соединение с хранилищем данных. При необходимости подпишите поток, чтобы уточнить операцию. Например, «Обновить запись» или «Получить баланс». Это снижает неопределённость на этапе разработки.
5. Взрыв процессов на диаграммах уровня 1 🧩
DFD иерархичны. Диаграмма контекста показывает систему как единый процесс. Уровень 0 разбивает его на основные подпроцессы. Уровень 1 дополнительно декомпозирует эти подпроцессы. Частая ошибка — помещать слишком много деталей на уровень 1.
Когда диаграмма уровня 1 становится перегруженной десятками крошечных процессов, она теряет свою ценность как карта высокого уровня. Она превращается в блок-схему, а не в диаграмму потоков данных. Цель уровня 1 — показать основные функциональные модули, а не каждый отдельный расчёт.
Если блок процесса содержит более пяти-семи подпроцессов, его следует разбить на отдельную диаграмму. Это сохраняет чистоту визуальной иерархии. Это позволяет зрителю понять структуру системы, не теряясь в деталях.
- Правило большого пальца:Если вы можете нарисовать диаграмму на одном стандартном листе без прокрутки, она, вероятно, уместна.
- Цель:Балансировать между детализацией и читаемостью.
6. Игнорирование петель обратной связи и управляющих данных 🔄
Системы редко бывают линейными. Они часто требуют обратной связи для корректировки поведения. Распространённой ошибкой является отсутствие диаграмм потоков управления или петель обратной связи. Например, пользователь может получить сообщение об ошибке и повторно ввести данные. Эта петля должна быть отображена.
Если на диаграмме показана прямая линия от входа к выходу, это подразумевает одностороннее движение. Реальные системы включают проверку, отклонение и повторную обработку. Игнорирование этих петель приводит к тому, что системы падают или ведут себя непредсказуемо при возникновении ошибок.
Включите путь, по которому данные возвращаются для исправления. Покажите процесс, который проверяет входные данные. Покажите процесс, который обрабатывает исключение. Это создаёт надёжную модель, учитывающую реальные сценарии использования.
7. Непоследовательные соглашения об именовании 📝
Ясность зависит от последовательности в языке. Использование «Пользователь» в одной части диаграммы и «Клиент» в другой вводит читателя в заблуждение. Аналогично, процесс, названный «Получить данные», рядом с процессом, названным «Извлечь информацию», может создать впечатление, что они выполняют разные действия.
Стандартизируйте терминологию. Создайте глоссарий для проекта и придерживайтесь его. Потоки данных должны называться существительными (например, «Детали заказа»), тогда как процессы — сочетанием глагола и существительного (например, «Рассчитать итог»).
Последовательность способствует коммуникации. Когда разработчики читают диаграмму, они не должны гадать, что означает тот или иной термин. Это снижает риск недопонимания и переделок на более поздних этапах жизненного цикла разработки.
Влияние ошибок на проектирование системы 📊
Почему важна такая степень точности? Ошибки в диаграммах потоков данных (DFD) распространяются на весь жизненный цикл разработки программного обеспечения. Отсутствие сущности может привести к отсутствию конечной точки API. Нарушенный поток данных может вызвать исключение нулевого указателя в производственной среде.
Кроме того, поддержка системы становится затруднительной. Если документация не соответствует коду, будущим инженерам придётся тратить больше времени на догадки, чем на разработку. Исправление ошибки в DFD на раннем этапе значительно дешевле, чем устранение дефекта в уже развёрнутой системе.
Контрольный список для проверки ✅
Перед финализацией диаграммы проверьте следующие пункты:
- Определены и подписаны все внешние сущности?
- Имеет ли каждый хранилище данных доступ на чтение и запись?
- Проходят ли все потоки данных через процесс?
- Правильно ли указаны направления стрелок для хранилищ данных?
- Не слишком ли сложна диаграмма уровня 1?
- Включены ли петли обратной связи и пути обработки ошибок?
- Согласованы ли названия на протяжении всего документа?
Соблюдение этих принципов гарантирует, что ваши диаграммы потоков данных будут точными, надёжными и полезными инструментами для проектирования архитектуры системы. Уделите время проверке своей работы на соответствие этим распространённым ошибкам.