

每个复杂的系统都始于想法、需求和约束的集合。这些就是需求。然而,用自然语言编写的需求往往存在歧义,容易误解,且难以从技术上验证。为了弥合利益相关者的期望与工程师构建内容之间的差距,我们需要一种可视化语言。这正是数据流图(DFD)变得不可或缺的地方。🧭
数据流图不仅仅是一幅绘图;它是一个逻辑模型,用于映射信息如何在系统中流动。它剥离了物理实现的细节,专注于数据本身的流动。本文探讨了将原始需求转化为结构化、已验证的数据流模型的严谨过程。
理解基础:需求分析 📝
在绘制任何箭头之前,必须充分理解输入内容。需求分析是模型赖以建立的基础。如果没有坚实的基础,上述结构将是不稳定的。
功能性需求与非功能性需求
DFD 主要建模功能性行为。它们回答的问题是:“系统对数据做了什么?”非功能性需求(如性能、安全性或延迟)会影响物理设计,但通常不会作为节点出现在 DFD 中。然而,它们规定了数据流动的约束条件。
- 功能性需求:系统必须执行的具体行为或功能(例如:“系统必须根据地区计算税款。”)。
- 非功能性需求:质量属性(例如:“计算必须在 2 秒内完成。”)。
收集输入
模型的信息来源于各种渠道。访谈、用户故事和现有文档提供了原始素材。目标是识别所有与系统交互的实体以及所有进入或离开系统的数据。
在收集这些信息时,请寻找动词。动词通常表示过程。名词通常表示数据对象或实体。这种语言线索有助于对图表进行初步范围界定。
数据流图的核心概念 🗺️
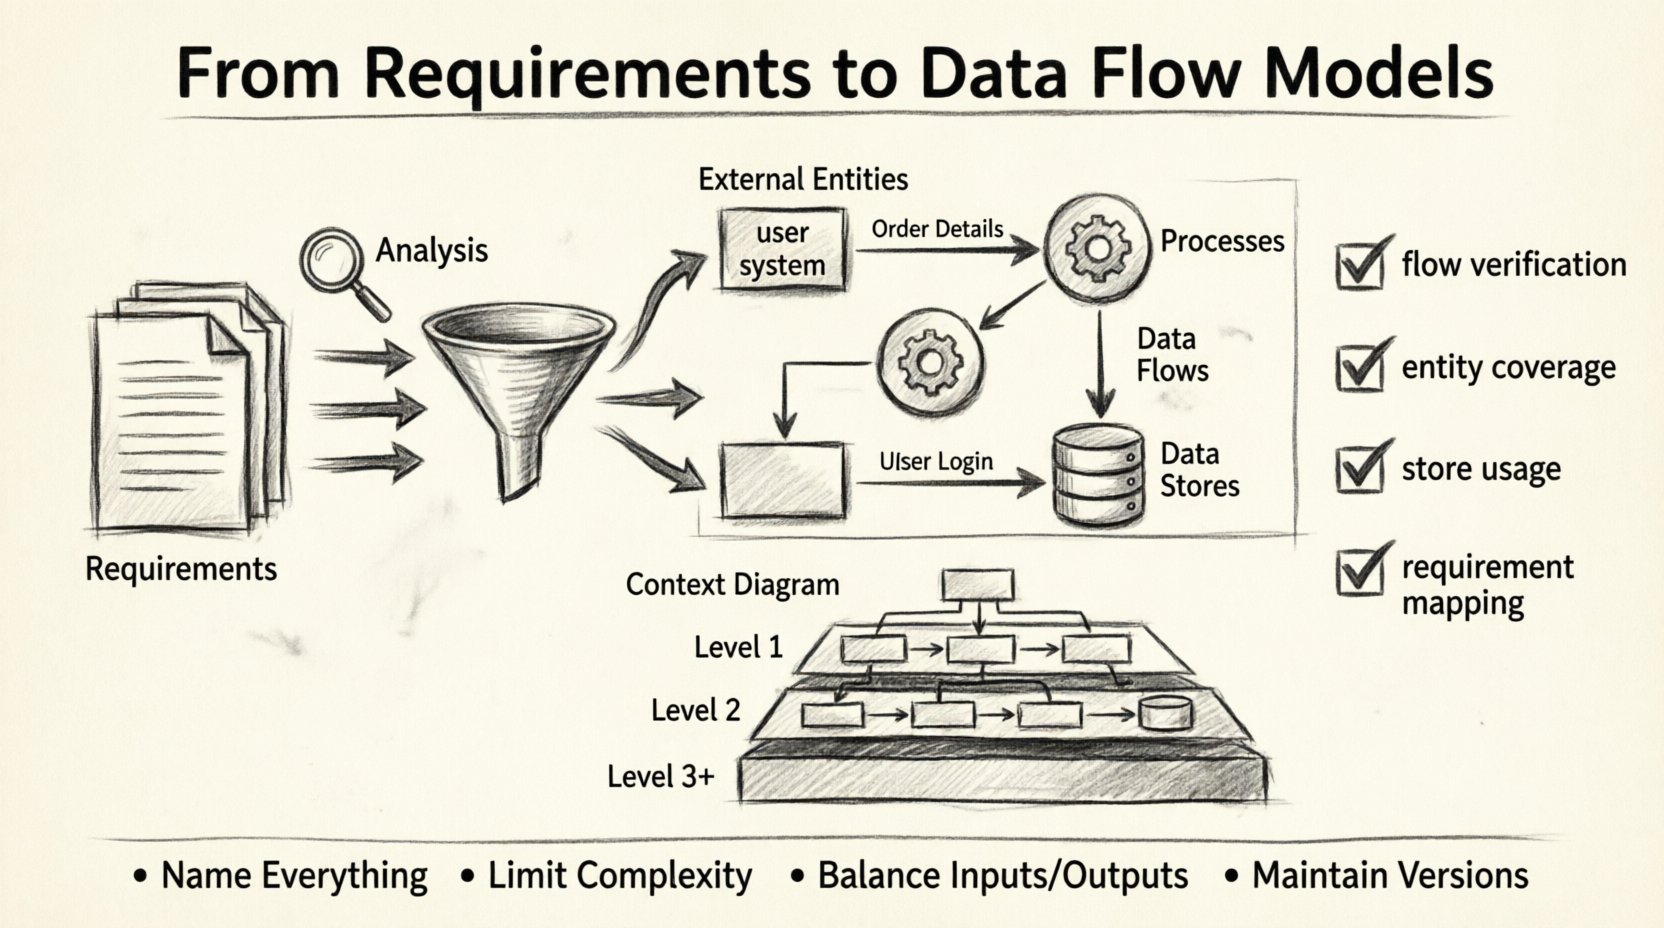
要构建有效的模型,必须遵循标准符号。虽然符号略有差异,但核心概念保持一致。数据流图由四个主要组成部分构成。
1. 外部实体(参与者)
这些是系统边界之外的数据来源或目的地。它们可以是人、其他系统或组织。在 DFD 中,它们通常用矩形表示。
2. 过程(转换)
过程将输入数据转换为输出数据。它们是系统的主动元素。在 DFD 中,它们通常用圆形或圆角矩形表示。一个过程必须至少有一个输入和一个输出。
3. 数据流(移动)
这些是显示数据移动方向的箭头。它们连接实体、过程和数据存储。每个流都必须有一个标签,描述正在移动的信息(例如:“订单详情”)。
4. 数据存储(记忆)
这些代表用于后续存储数据的地方。它们是被动存储库。在 DFD 中,它们通常表示为开口矩形或平行线。数据存储不会触发操作;它等待被读取或写入。
转换过程:从文字到线条 🛠️
将文本转换为图表需要系统的方法。此过程涉及分解和抽象。你不能一次性绘制整个系统。你要从高层开始,然后逐步深入。
步骤 1:定义系统边界
决定什么在系统内部,什么在系统外部。内部的一切都是过程、存储或流。外部的一切都是外部实体。这个边界对于定义上下文至关重要。
步骤 2:识别上下文
创建一个上下文图(也称为 0 级数据流图)。这是最高抽象级别。它将整个系统表示为一个单一过程,并展示其与外部实体的交互。
- 过程:整个系统的名称。
- 实体:所有外部数据源和数据汇。
- 数据流:主要的数据输入和输出。
步骤 3:分解过程
一旦上下文确定,将单一过程分解为主要的子过程。这就是1 级数据流图。每个子过程应处理源自需求的一个独立功能。确保进入顶层的数据也进入其中一个子过程。
步骤 4:添加细节和数据存储
当您向下钻取到2 级及更高级别时,您会引入数据存储。这是逻辑变得具体的地方。您定义数据在步骤之间存储的位置。确保每个数据存储都至少连接到一个过程(您不能仅创建一个存储位置而没有更新或检索它的方法)。
抽象级别详解 📊
数据流图是分层级的。这允许利益相关者根据其理解程度查看系统的适当级别。下表概述了标准级别之间的差异。
| 级别 | 范围 | 主要关注点 | 典型受众 |
|---|---|---|---|
| 上下文图 | 整个系统 | 主要输入和输出 | 利益相关者、管理层 |
| 1 级 | 主要功能 | 关键过程和数据存储 | 项目经理、架构师 |
| 第二层 | 子过程 | 特定数据转换 | 开发人员、分析师 |
| 第三层及以上 | 原子过程 | 详细逻辑流程 | 工程师 |
请注意,随着层级编号的增加,复杂性也会提高。上下文图提供鸟瞰视图,而更深层级则提供详细的机制说明。
确保一致性与平衡 ⚖️
数据流图(DFD)建模中最关键的规则之一是平衡。当您分解一个过程时,父过程的输入和输出必须与所有子过程的输入和输出之和相匹配。您不能凭空创造或销毁数据。
如果一个第一层过程以“用户登录”作为输入,那么其某个子过程最终必须接受“用户登录”或其衍生版本。如果一个过程输出“报告”,该输出也必须出现在父图中。这确保了整个层级结构的逻辑完整性。
验证技术
如何确认模型是正确的?验证涉及多项检查:
- 流程验证: 追踪每一条从源到目的地的箭头。这是否合理?是否有相应的过程来处理它?
- 实体覆盖: 所有外部实体是否都在上下文图中表示?
- 数据存储使用情况: 是否访问了每个数据存储?未连接的数据存储通常是无效代码。
- 需求映射: 您能否将每个需求追溯到图中的某个过程或流程?
数据流建模中的挑战 ⚠️
创建这些模型并不总是 straightforward。分析师经常遇到可能阻碍进度或导致不准确表示的障碍。
需求中的歧义
如果初始需求模糊不清,图表也会同样模糊。例如,“处理订单”过于宽泛。它是指“接收订单”、“验证库存”还是“发货”?这是三个不同的过程,需要单独的节点。细化动词定义至关重要。
范围蔓延
在建模阶段,经常会出现新的需求。人们往往急于立即添加它们。然而,过早添加过多细节会使图表变得杂乱。更好的做法是将新需求记录在待办事项列表中,并在模型的下一轮迭代中处理它们。
与控制流的混淆
一个常见的错误是将控制逻辑与数据流混淆。数据流图(DFD)展示的是数据如何流动,而非数据何时流动。控制流图(如流程图)展示逻辑分支(如 if/else)。数据流图假设过程会发生,仅展示数据流经的路径。应专注于数据负载,而非决策逻辑。
长期维护模型 🔄
需求会发生变化,系统也会不断演进。数据流图并非一次性绘制后归档的静态产物,而必须作为一份动态文档持续维护。
当需求发生变更时,需追溯其影响。如果新增了数据字段,是否改变了数据流?是否需要新增数据存储?应立即更新图表。这能确保文档与实际情况保持一致。
版本控制同样必不可少。随着模型的发展,旧版本对于审计或理解遗留逻辑仍具有参考价值。对版本进行标注(例如 DFD_v1.0、DFD_v2.0)有助于追踪系统设计的演进过程。
提升清晰度的最佳实践 ✨
为确保模型发挥其作用,请遵循以下指南以实现有效沟通。
- 命名所有元素:实体、处理过程和数据流必须具有清晰、描述性的名称。除非是行业标准,否则应避免使用缩写。
- 限制复杂度:如果单个处理过程拥有超过七个输入或输出,则可能过于复杂,应进一步分解。
- 最小化线条交叉:虽然并非总能实现,但应尽量安排图表,使箭头不产生过多交叉,以提升可读性。
- 使用一致的符号:在整个文档中坚持使用一种符号表示法(例如 Gane & Sarson 或 Yourdon & DeMarco)。
系统设计总结 🏁
从需求到数据流模型的构建过程,是一门关于清晰性的学科。它要求剥离实现层面的噪音,以洞察信息的核心流动。通过遵循分解、平衡和验证的原则,您将创建一份工程师可以信赖、利益相关者能够理解的蓝图。
该模型将成为数据库设计、API 定义和接口规范的参考基准,使项目扎根于现实。当需求稳固时,图表便是指引团队抵达目标的地图。请始终聚焦于数据,尊重边界,并确保每一条箭头都讲述一个故事。