

すべての複雑なシステムは、アイデア、ニーズ、制約の集まりとして始まります。これらが要件です。しかし、自然言語で書かれた要件は曖昧であり、誤解されやすく、技術的に検証することが困難な場合が多々あります。ステークホルダーが求めるものとエンジニアが構築するものの間のギャップを埋めるためには、視覚的な言語が必要です。ここでデータフロー図(DFD)が不可欠なものとなります。🧭
データフロー図は単なる図ではありません。それは、情報がシステム内をどのように移動するかをマッピングする論理モデルです。物理的な実装の詳細を排除し、データそのもののフローに焦点を当てます。この記事では、生来の要件を構造化され検証済みのデータフローモデルに変換する厳密なプロセスを探ります。
基盤の理解:要件分析 📝
矢印を一つ描く前に、入力を完全に理解する必要があります。要件分析は、モデルが立つための基盤です。堅固な基盤がなければ、その上の構造は不安定になります。
機能的要件と非機能的要件
DFDは主に「機能的」の動作をモデル化します。それらは「システムはデータをどのように処理するか?」という問いに答えます。非機能的要件(パフォーマンス、セキュリティ、レイテンシなど)は物理的な設計に影響を与えますが、通常DFDのノードとして現れることはありません。ただし、データが流れる制約を決定します。
- 機能的要件:システムが実行しなければならない特定の動作や機能(例:「システムは地域に基づいて税金を計算しなければならない」)。
- 非機能的要件:品質属性(例:「計算は2秒以内に完了しなければならない」)。
入力の収集
モデルに必要な情報はさまざまなソースから得られます。インタビュー、ユーザーストーリー、既存のドキュメントが原材料となります。目標は、システムと相互作用するすべてのエンティティと、システムに入力または出力されるすべてのデータ項目を特定することです。
この情報を収集する際は、動詞を探してください。動詞はプロセスを示すことが多く、名詞はデータオブジェクトやエンティティを示すことがよくあります。この言語的な手がかりは、図の初期のスコーピングに役立ちます。
データフロー図の核心概念 🗺️
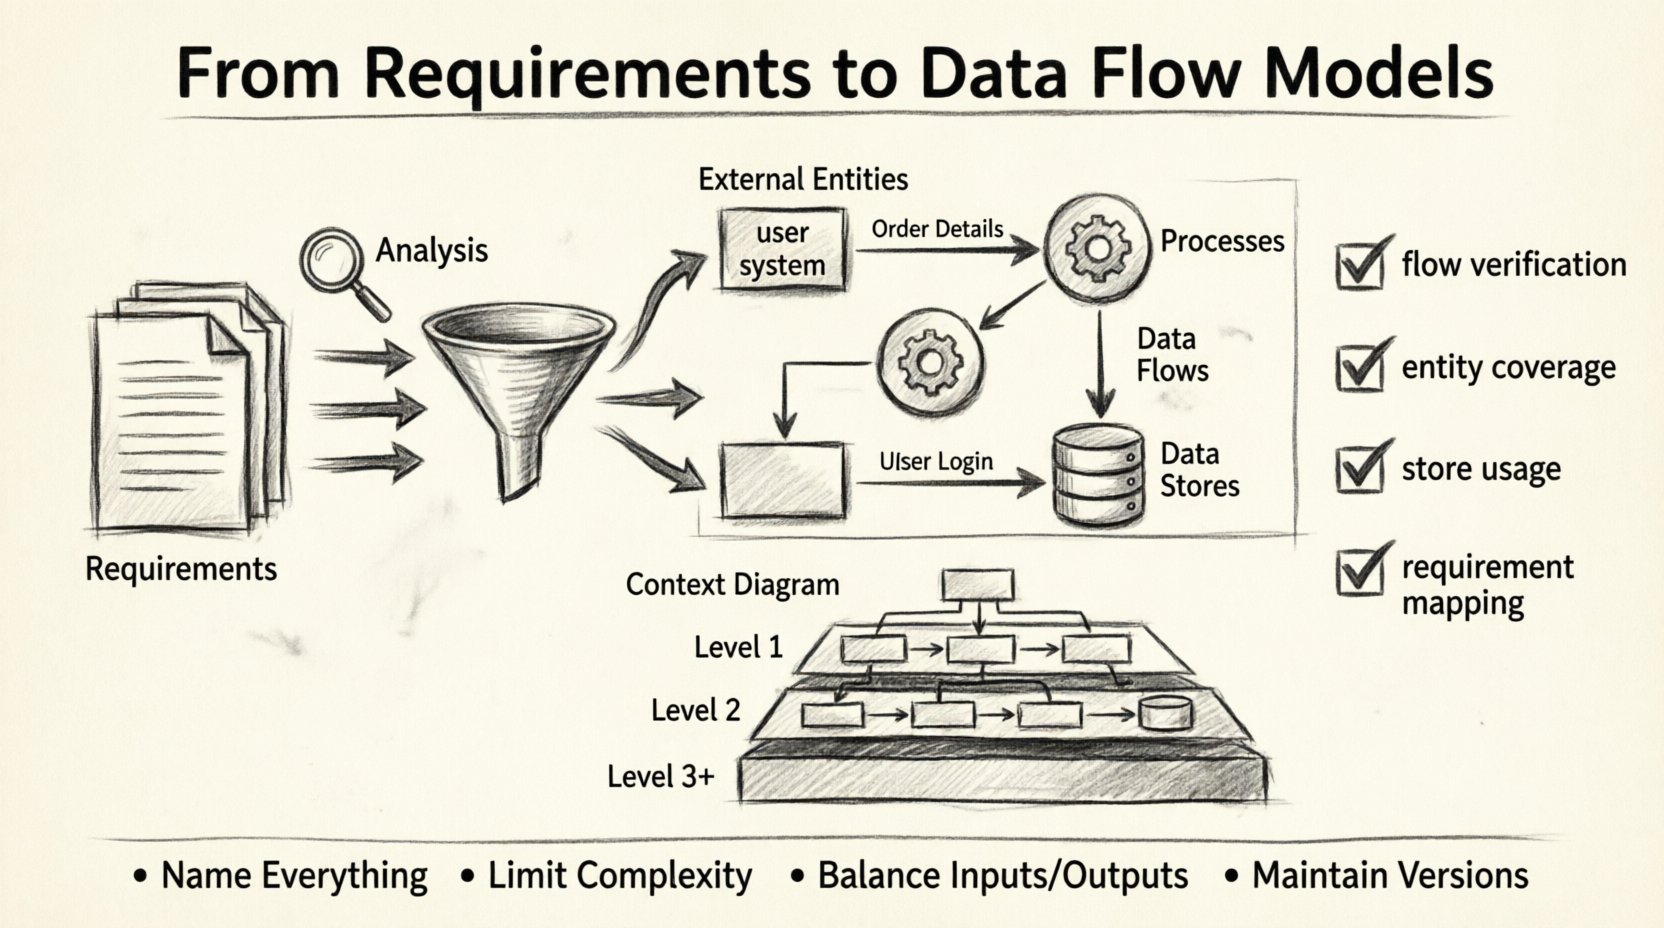
有効なモデルを構築するには、標準的な記法に従う必要があります。記法はわずかに異なる場合がありますが、核心概念は一定です。データフロー図を構成する4つの主要なコンポーネントがあります。
1. 外部エンティティ(アクター)
これらはシステム境界の外にあるデータのソースまたは宛先です。人、他のシステム、または組織である可能性があります。DFDでは、通常、長方形で表されます。
2. プロセス(変換)
プロセスは入力データを出力データに変換します。それらはシステムの能動的な要素です。DFDでは、通常、円または角丸長方形で表されます。プロセスは少なくとも1つの入力と1つの出力を持たなければなりません。
3. データフロー(移動)
これらはデータ移動の方向を示す矢印です。エンティティ、プロセス、データストアを接続します。すべてのフローには、移動している情報が何であるかを説明するラベルが必要です(例:「注文詳細」)。
4. データストア(記憶)
これらは、データを後で使用するために保持する場所を表します。それらは受動的なリポジトリです。DFDでは、通常、開いた長方形または平行線として描かれます。データストアはアクションを引き起こすものではなく、読み取りまたは書き込みを待機するものです。
変換プロセス:言葉から線へ 🛠️
テキストを図に変換するには、体系的なアプローチが必要です。このプロセスには分解と抽象化が含まれます。システム全体を一度に描くわけではありません。高いレベルから始めて、詳細へと掘り下げていきます。
ステップ1:システム境界を定義する
システムの内側と外側を決定します。内側にあるものはすべてプロセス、ストア、またはフローです。外側にあるものはすべて外部エンティティです。この境界は文脈を定義する上で極めて重要です。
ステップ2:文脈を特定する
「コンテキスト図(レベル 0 DFD とも呼ばれます)。これは最も抽象度の高いレベルです。システム全体を単一のプロセスとして示し、外部エンティティとの相互作用を表します。
- プロセス:システム全体の名称。
- エンティティ:すべての外部ソースとシンク。
- フロー:主要なデータ入力と出力。
ステップ 3:プロセスの分解
コンテキストが確立されたら、単一のプロセスを主要なサブプロセスに分解します。これはレベル 1 DFDです。各サブプロセスは、要件から導き出された固有の機能を処理する必要があります。トップレベルに入るデータが、いずれかのサブプロセスにも入るようにしてください。
ステップ 4:詳細とストレージの追加
レベル 2以降、データストアを導入します。ここでロジックが具体化されます。ステップ間のデータの保管場所を定義します。すべてのデータストアが少なくとも 1 つのプロセスに接続されていることを確認してください(更新または取得する方法なしに単に保存場所を作成することはできません)。
抽象度のレベルの説明 📊
DFD は階層的です。これにより、利害関係者は自分の理解に合ったレベルでシステムを見ることができます。以下の表は、標準的なレベル間の違いを概説しています。
| レベル | 範囲 | 主な焦点 | 一般的な対象者 |
|---|---|---|---|
| コンテキスト図 | システム全体 | 主要な入力と出力 | 利害関係者、経営陣 |
| レベル 1 | 主要な機能 | 主要なプロセスとデータストア | プロジェクトマネージャー、アーキテクト |
| レベル 2 | サブプロセス | 特定のデータ変換 | 開発者、アナリスト |
| レベル 3+ | 原子プロセス | 詳細なロジックフロー | エンジニア |
レベル番号が上がるにつれて複雑さが増すことに注意してください。コンテキスト図は全体像(鳥瞰図)を提供しますが、より深いレベルでは詳細なメカニクスが示されます。
一貫性とバランスの確保 ⚖️
DFDモデリングにおける最も重要なルールの一つはバランス。プロセスを分解する際、親プロセスの入力と出力は、子プロセスすべての入力と出力の合計と一致しなければなりません。データは空中から生み出したり消滅させたりすることはできません。
レベル 1 のプロセスが「ユーザーログイン」を入力とする場合、その子プロセスの少なくとも一つは最終的に「ユーザーログイン」またはその派生バージョンを受け入れる必要があります。あるプロセスが「レポート」を出力する場合、その出力は親図にも表示されなければなりません。これにより、階層全体で論理的整合性が保たれます。
検証手法
モデルが正しいことをどうやって確認しますか?検証にはいくつかの確認が必要です:
- フローの検証: 矢印をソースから宛先まですべて追跡します。意味が通じますか?それを処理するプロセスはありますか?
- エンティティのカバレッジ: 外部エンティティはすべてコンテキスト図に表現されていますか?
- ストレージの使用状況: すべてのデータストアがアクセスされていますか?接続されていないストアは多くの場合、死んだコード(使用されていないコード)です。
- 要件のマッピング: 各要件を、図内のプロセスまたはフローに遡って追跡できますか?
データフローモデリングにおける課題 ⚠️
これらのモデルを作成することは常に簡単ではありません。アナリストは、進捗を停滞させたり、不正確な表現につながったりする障害にしばしば直面します。
要件の曖昧さ
初期要件が曖昧な場合、図も曖昧になります。例えば、「注文処理」は広すぎます。これは「注文の受領」を意味しますか、「在庫の確認」を意味しますか、それとも「商品の出荷」を意味しますか?これらは別々のノードを必要とする 3 つの明確なプロセスです。動詞の定義を明確にすることが不可欠です。
スコープクリープ
モデリングフェーズ中には、新しい要件が頻繁に現れます。それらをすぐに追加したくなるものです。しかし、早期に詳細を多く追加しすぎると、図がごちゃごちゃになってしまいます。新しい要件はバックログに記録し、モデルの次のイテレーションで対応することをお勧めします。
制御フローとの混同
よくある誤りは、制御ロジックとデータフローを混同することです。DFDは、どのデータが移動するかを示し、いつ移動するかは示しません。制御フロー図(フローチャートなど)は、ロジックの分岐(if/else)を示します。DFDはプロセスが発生することを前提としており、データが通過する様子を示すだけです。焦点は意思決定ロジックではなく、データペイロードに置くべきです。
時間の経過に伴うモデルの維持管理 🔄
要件は変化します。システムは進化します。DFDは一度描いて棚にしまう静的な成果物ではありません。それは生きた文書として維持されなければなりません。
要件が変更された場合、その影響を追跡してください。新しいデータフィールドが追加された場合、フローは変わりますか?新しいストレージが必要になりますか?図をすぐに更新してください。これにより、ドキュメントが現実と整合性保たれます。
バージョン管理も必要です。モデルが成長するにつれて、古いバージョンは監査やレガシーロジックの理解に重要になります。バージョンにラベルを付ける(例:DFD_v1.0、DFD_v2.0)ことで、システム設計の進化を追跡しやすくなります。
明確さのためのベストプラクティス ✨
モデルがその目的を果たすことを確保するために、効果的なコミュニケーションのための以下のガイドラインに従ってください。
- すべてに名前を付ける:エンティティ、プロセス、フローはすべて、明確で説明的な名前を持つ必要があります。業界標準でない限り、略語は避けてください。
- 複雑さを制限する:単一のプロセスに7つ以上の入力または出力がある場合、それはおそらく複雑すぎます。さらに分解してください。
- 交差する線を最小限に抑える:常に可能とは限りませんが、矢印が過度に交差しないように図を配置するように努めてください。これにより可読性が向上します。
- 一貫した記号を使用する:文書全体で1つの表記スタイル(例:Gane & Sarson、またはYourdon & DeMarco)に統一してください。
システム設計に関する結論 🏁
要件からデータフローモデルへの道筋は、明確さという学問です。実装のノイズを取り除いて、情報の核心的な動きを見る必要があります。分解、バランス、検証の原則に従うことで、エンジニアが信頼し、利害関係者が理解できる設計図を作成できます。
このモデルは、データベース設計、API定義、インターフェース仕様の基準点となります。それはプロジェクトを現実に根付かせます。要件が堅固であれば、図はチームを目的地へ導く地図となります。データに焦点を当て、境界を尊重し、すべての矢印が物語を語ることを確保してください。