

Каждая сложная система начинается с набора идей, потребностей и ограничений. Это и есть требования. Однако требования, записанные на естественном языке, часто бывают двусмысленными, подвержены неправильному толкованию и трудно поддаются технической валидации. Чтобы преодолеть разрыв между тем, чего хотят заинтересованные стороны, и тем, что строят инженеры, нам нужен визуальный язык. Именно здесь диаграммы потоков данных (DFD) становятся незаменимыми. 🧭
Диаграмма потоков данных — это не просто рисунок; это логическая модель, отображающая, как информация перемещается через систему. Она устраняет детали физической реализации, чтобы сосредоточиться на самом потоке данных. В этой статье рассматривается строгий процесс преобразования сырых требований в структурированную и валидированную модель потока данных.
Понимание фундамента: анализ требований 📝
Прежде чем нарисовать хотя бы одну стрелку, необходимо полностью понять входные данные. Анализ требований — это фундамент, на котором стоит модель. Без прочного фундамента надстройка будет нестабильной.
Функциональные и нефункциональные потребности
DFD в первую очередь моделируют функциональное поведение. Они отвечают на вопрос: «Что система делает с данными?» Нефункциональные требования (такие как производительность, безопасность или задержка) влияют на физический дизайн, но обычно не отображаются в виде узлов на DFD. Однако они определяют ограничения, в которых происходит поток данных.
- Функциональные требования: Конкретное поведение или функции, которые система должна выполнять (например, «Система должна рассчитывать налог в зависимости от региона»).
- Нефункциональные требования: Качественные характеристики (например, «Расчет должен быть завершен в течение 2 секунд»).
Сбор входных данных
Информация для модели поступает из различных источников. Интервью, пользовательские истории и существующая документация предоставляют сырой материал. Цель состоит в том, чтобы выявить все сущности, взаимодействующие с системой, и все данные, которые входят в нее или выходят из нее.
При сборе этой информации обращайте внимание на глаголы. Глаголы часто указывают на процессы. Существительные часто указывают на объекты данных или сущности. Этот лингвистический сигнал помогает на начальном этапе определить границы диаграммы.
Основные концепции диаграмм потоков данных 🗺️
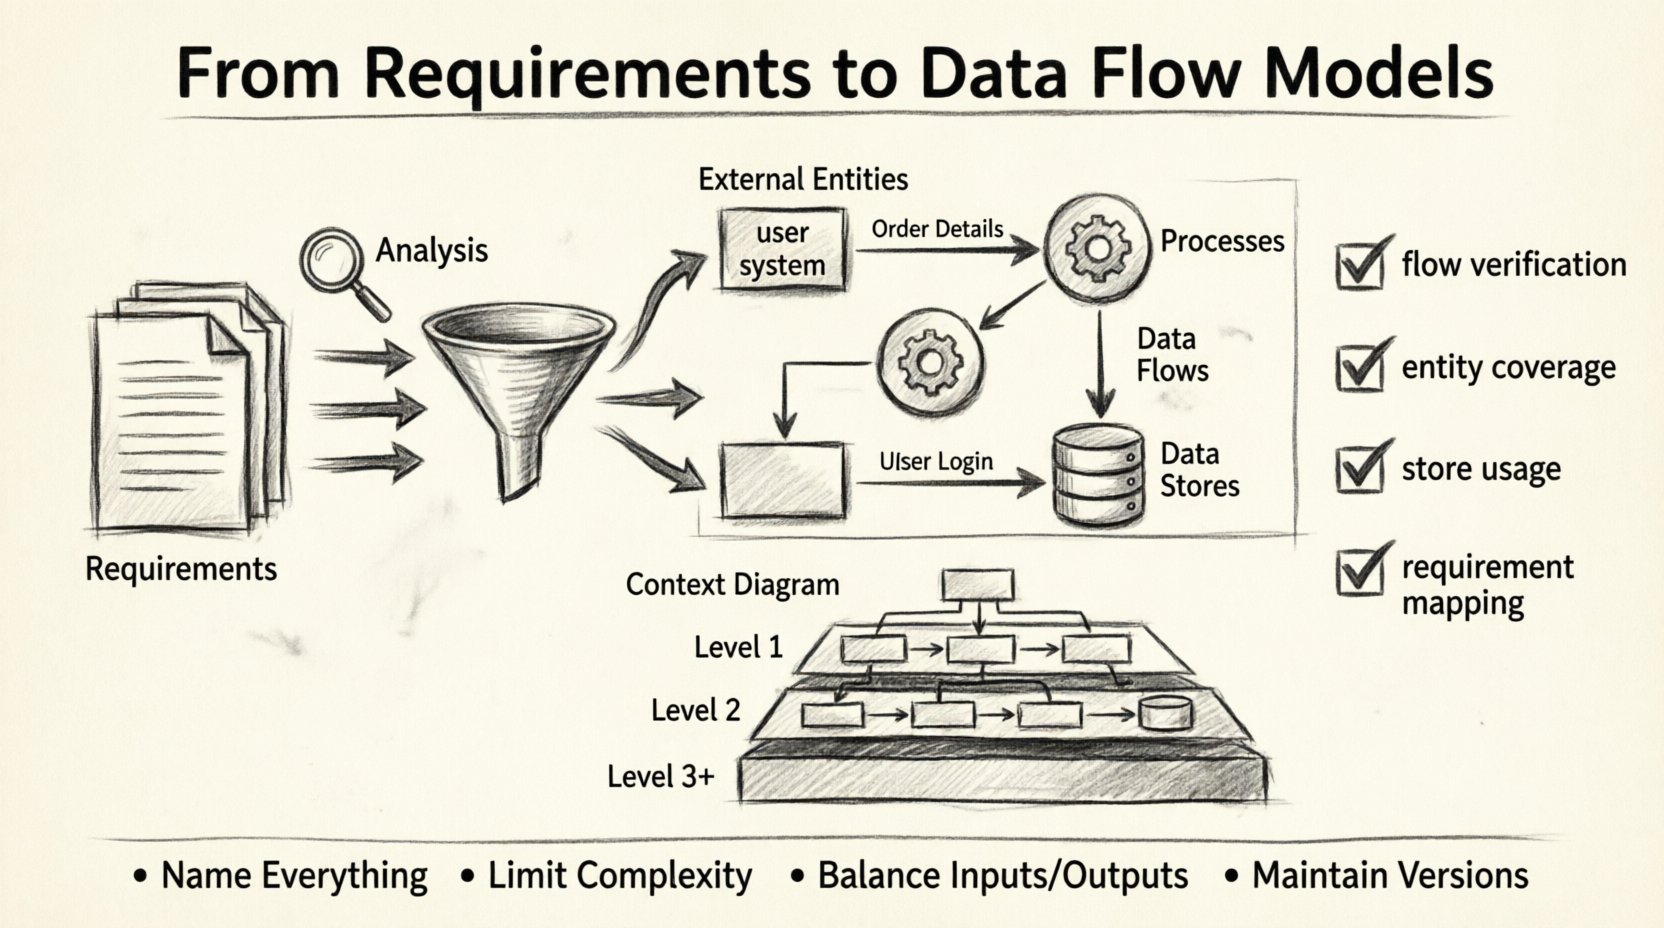
Чтобы построить валидную модель, необходимо придерживаться стандартной нотации. Хотя нотации могут незначительно отличаться, основные концепции остаются неизменными. Существует четыре основных компонента, из которых состоит диаграмма потоков данных.
1. Внешние сущности (Актеры)
Это источники или получатели данных за пределами границы системы. Это могут быть люди, другие системы или организации. На DFD они обычно изображаются в виде прямоугольников.
2. Процессы (Преобразования)
Процессы преобразуют входные данные в выходные. Это активные элементы системы. На DFD они обычно изображаются в виде кругов или скругленных прямоугольников. Процесс должен иметь как минимум один вход и один выход.
3. Потоки данных (Перемещение)
Это стрелки, показывающие направление движения данных. Они соединяют сущности, процессы и хранилища данных. Каждый поток должен иметь метку, описывающую, какая информация перемещается (например, «Детали заказа»).
4. Хранилища данных (Память)
Они представляют собой места, где данные хранятся для последующего использования. Это пассивные хранилища. На DFD они часто изображаются в виде прямоугольников с открытым концом или параллельных линий. Хранилище данных не инициирует действие; оно ждет, пока из него прочитают данные или запишут в него.
Процесс перевода: от слов к линиям 🛠️
Преобразование текста в диаграмму требует систематического подхода. Этот процесс включает декомпозицию и абстракцию. Вы не рисуете всю систему сразу. Вы начинаете с высокого уровня и постепенно углубляетесь.
Шаг 1: Определите границу системы
Решите, что находится внутри системы, а что — снаружи. Все внутри — это процесс, хранилище или поток. Все снаружи — внешняя сущность. Эта граница критически важна для определения контекста.
Шаг 2: Определите контекст
Создайте Контекстная диаграмма (также известная как DFD уровня 0). Это самый высокий уровень абстракции. Она показывает всю систему как единый процесс и её взаимодействие с внешними сущностями.
- Процесс: Полное название системы.
- Сущности: Все внешние источники и стоки.
- Потоки: Основные входы и выходы данных.
Шаг 3: Декомпозиция процесса
После установления контекста разбейте единый процесс на основные подпроцессы. Это DFD уровня 1. Каждый подпроцесс должен выполнять отдельную функцию, выведенную из требований. Убедитесь, что данные, поступающие на верхний уровень, также поступают в один из подпроцессов.
Шаг 4: Добавление деталей и хранилищ
По мере углубления в уровень 2 и далее вы вводите хранилища данных. Здесь логика становится конкретной. Вы определяете, где данные хранятся между шагами. Убедитесь, что каждое хранилище данных связано как минимум с одним процессом (нельзя просто создать место хранения без возможности его обновления или извлечения).
Объяснение уровней абстракции 📊
DFD иерархичны. Это позволяет заинтересованным сторонам рассматривать систему на уровне, соответствующем их пониманию. В следующей таблице приведены различия между стандартными уровнями.
| Уровень | Область охвата | Основной фокус | Типичная аудитория |
|---|---|---|---|
| Контекстная диаграмма | Система в целом | Основные входы и выходы | Заинтересованные стороны, руководство |
| Уровень 1 | Основные функции | Ключевые процессы и хранилища данных | Руководители проектов, архитекторы |
| Уровень 2 | Подпроцессы | Конкретные преобразования данных | Разработчики, аналитики |
| Уровень 3+ | Атомарные процессы | Детальный поток логики | Инженеры |
Обратите внимание, что сложность возрастает по мере увеличения номера уровня. Диаграмма контекста обеспечивает обзор «с высоты птичьего полета», в то время как более глубокие уровни предоставляют детальную механику.
Обеспечение согласованности и баланса ⚖️
Одним из самых важных правил моделирования DFD является балансировка. При декомпозиции процесса входы и выходы родительского процесса должны совпадать с суммарными входами и выходами дочерних процессов. Вы не можете создавать или уничтожать данные из ничего.
Если процесс уровня 1 принимает «Вход пользователя» в качестве входа, один из его дочерних процессов в конечном итоге должен принимать «Вход пользователя» или его производную версию. Если процесс выдает «Отчет», этот выход должен также присутствовать на диаграмме родительского уровня. Это обеспечивает логическую целостность во всей иерархии.
Техники валидации
Как узнать, что модель верна? Валидация включает несколько проверок:
- Проверка потоков: Отследите каждую стрелку от источника к назначению. Это имеет смысл? Есть ли процесс для её обработки?
- Охват сущностей: Все ли внешние сущности представлены на диаграмме контекста?
- Использование хранилищ: Доступно ли каждое хранилище данных? Не подключенные хранилища часто являются «мертвым кодом».
- Сопоставление требований: Можете ли вы отследить каждое требование до процесса или потока на диаграмме?
Сложности моделирования потоков данных ⚠️
Создание таких моделей не всегда является простым делом. Аналитики часто сталкиваются с препятствиями, которые могут замедлить прогресс или привести к неточным представлениям.
Неопределенность в требованиях
Если первоначальные требования размыты, диаграмма тоже будет размытой. Например, «Обработка заказа» слишком общее понятие. Означает ли это «Получение заказа», «Проверка наличия» или «Отгрузка товаров»? Это три различных процесса, требующие отдельных узлов. Уточнение определений глаголов имеет решающее значение.
Расползание границ проекта
В фазе моделирования часто возникают новые требования. Сложно удержаться от того, чтобы не добавить их немедленно. Однако добавление слишком большого количества деталей слишком рано может перегрузить диаграмму. Лучше зафиксировать новые требования в бэклоге и решить их в следующей итерации модели.
Путаница с потоками управления
Распространённая ошибка — смешивать логику управления с потоком данных. DFD показывают какие данные перемещаются, а не когда они перемещаются. Диаграммы потока управления (например, блок-схемы) показывают логические ветвления (if/else). DFD предполагают, что процесс выполняется; они лишь показывают прохождение данных. Сохраняйте фокус на самих данных, а не на логике принятия решений.
Поддержка модели во времени 🔄
Требования меняются. Системы развиваются. DFD — это не статичный артефакт, который рисуется один раз и归档руется. Его необходимо поддерживать как живой документ.
Когда требование изменяется, отследите последствия. Если добавляется новое поле данных, меняется ли поток? Требуется ли новый хранилище? Немедленно обновите диаграмму. Это обеспечивает соответствие документации реальности.
Также необходим контроль версий. По мере роста модели старые версии становятся актуальными для аудита или понимания унаследованной логики. Маркировка версий (например, DFD_v1.0, DFD_v2.0) помогает отслеживать эволюцию проектирования системы.
Рекомендации для ясности ✨
Чтобы модель выполняла свою задачу, следуйте этим рекомендациям для эффективной коммуникации.
- Называйте всё:Сущности, процессы и потоки должны иметь чёткие, описательные названия. Избегайте сокращений, если они не являются отраслевым стандартом.
- Ограничивайте сложность:Если у одного процесса более семи входов или выходов, он, вероятно, слишком сложен. Декомпозируйте его дальше.
- Минимизируйте пересечения линий:Хотя это не всегда возможно, постарайтесь расположить диаграмму так, чтобы стрелки не пересекались чрезмерно. Это улучшает читаемость.
- Используйте согласованные символы:Соблюдайте один стиль нотации (например, Gane & Sarson или Yourdon & DeMarco) на протяжении всего документа.
Заключение о проектировании системы 🏁
Путь от требований к модели потока данных — это дисциплина ясности. Она требует устранения шума реализации, чтобы увидеть основное движение информации. Соблюдая принципы декомпозиции, балансировки и валидации, вы создаёте чертеж, которому могут доверять инженеры и который могут понять заинтересованные стороны.
Эта модель становится точкой отсчёта для проектирования баз данных, определений API и спецификаций интерфейсов. Она закрепляет проект в реальности. Когда требования надёжны, диаграмма — это карта, которая ведёт команду к цели. Сохраняйте фокус на данных, уважайте границы и убедитесь, что каждая стрелка рассказывает историю.