

Każdy złożony system zaczyna się jako zbiór pomysłów, potrzeb i ograniczeń. To są wymagania. Jednak wymagania zapisane w języku naturalnym są często niejednoznaczne, podatne na błędną interpretację i trudne do zweryfikowania technicznie. Aby zniwelować lukę między tym, czego oczekują interesariusze, a tym, co budują inżynierowie, potrzebujemy języka wizualnego. Właśnie tutaj Diagramy Przepływu Danych (DFD) stają się nieodzowne. 🧭
Diagram Przepływu Danych to nie tylko rysunek; to model logiczny, który mapuje sposób przemieszczania się informacji przez system. Eliminuje on szczegóły fizycznej implementacji, skupiając się na samym przepływie danych. Niniejszy artykuł przedstawia rygorystyczny proces przekształcania surowych wymagań w ustrukturyzowany, zweryfikowany model przepływu danych.
Zrozumienie fundamentów: Analiza wymagań 📝
Zanim narysujemy choćby jedną strzałkę, należy w pełni zrozumieć dane wejściowe. Analiza wymagań to grunt, na którym stoi model. Bez solidnych fundamentów struktura powyżej będzie niestabilna.
Wymagania funkcjonalne vs. niefunkcjonalne
DFD modelują głównie funkcjonalne zachowanie. Odpowiadają na pytanie: „Co system robi z danymi?”. Wymagania niefunkcjonalne (takie jak wydajność, bezpieczeństwo czy opóźnienia) wpływają na projekt fizyczny, ale zazwyczaj nie pojawiają się jako węzły w DFD. Określają jednak ograniczenia, w których poruszają się dane.
- Wymagania funkcjonalne: Określone zachowania lub funkcje, które system musi realizować (np. „System musi obliczyć podatek w zależności od regionu.”).
- Wymagania niefunkcjonalne: Atrybuty jakościowe (np. „Obliczenia muszą zostać zakończone w ciągu 2 sekund.”).
Zbieranie danych wejściowych
Informacje do modelu pochodzą z różnych źródeł. Wywiady, historie użytkownika i istniejąca dokumentacja dostarczają surowego materiału. Celem jest zidentyfikowanie każdej encji interagującej z systemem oraz każdego elementu danych, który do niego wchodzi lub z niego wychodzi.
Podczas zbierania tych informacji szukaj czasowników. Czasowniki często wskazują na procesy. Rzeczowniki często oznaczają obiekty danych lub encje. Ta wskazówka językowa pomaga w wstępnym określeniu zakresu diagramu.
Podstawowe koncepcje Diagramów Przepływu Danych 🗺️
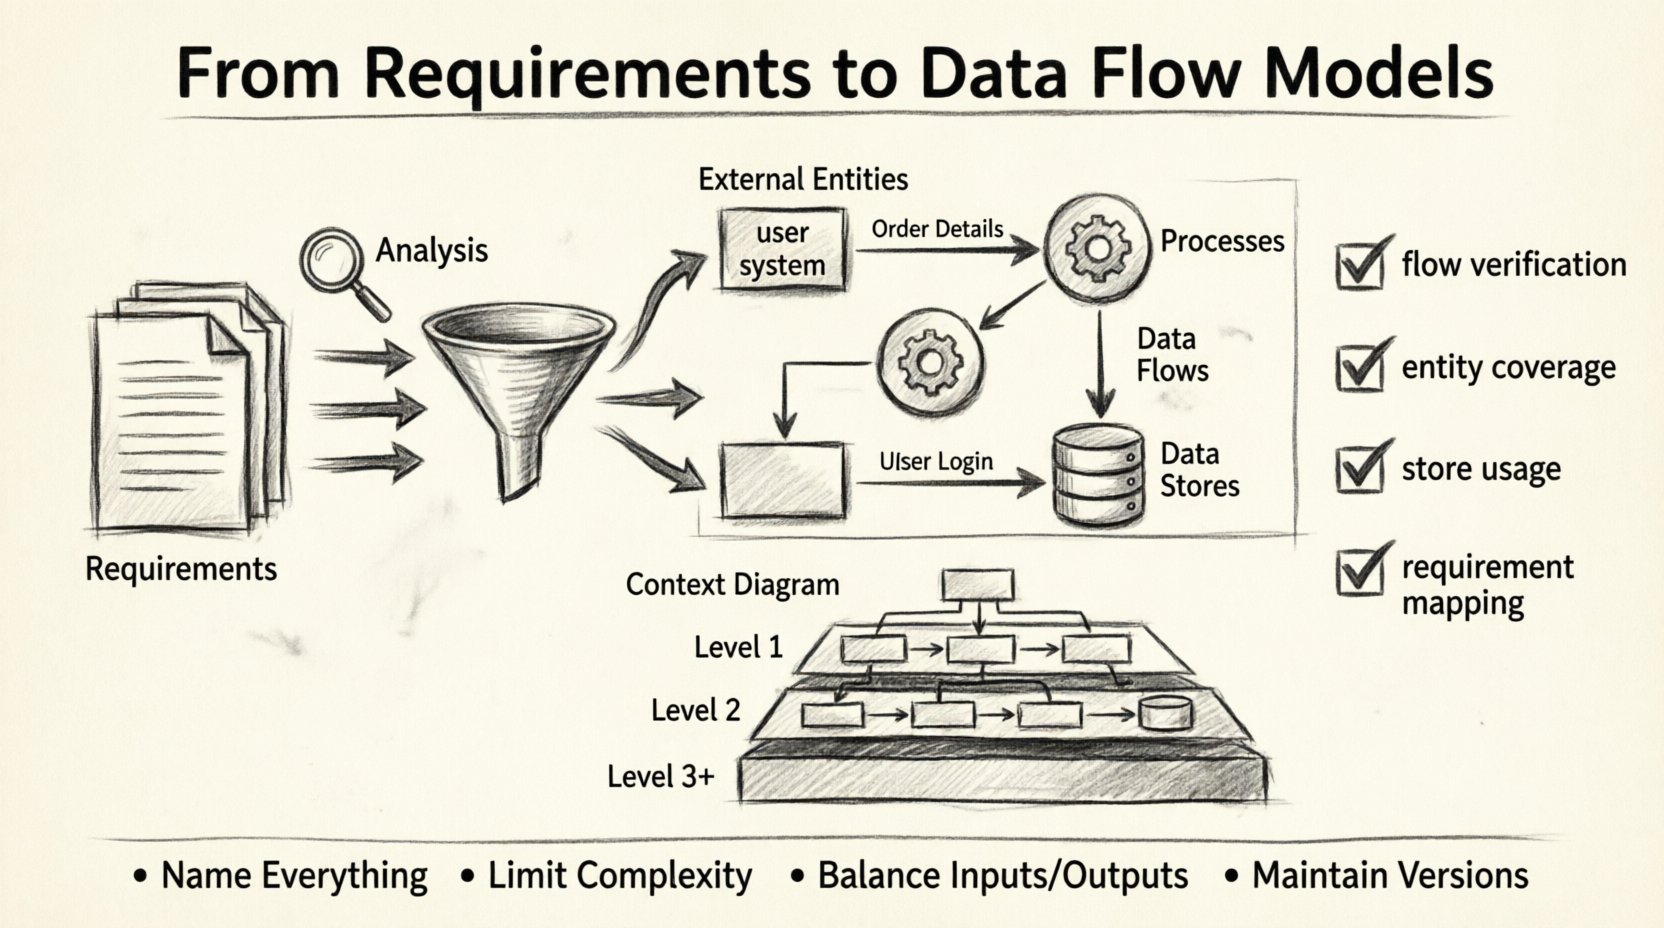
Aby zbudować poprawny model, należy przestrzegać standardowej notacji. Choć notacje mogą się nieznacznie różnić, podstawowe koncepcje pozostają spójne. Istnieją cztery główne komponenty składające się na Diagram Przepływu Danych.
1. Encje zewnętrzne (Aktorzy)
Są to źródła lub miejsca przeznaczenia danych poza granicami systemu. Mogą to być ludzie, inne systemy lub organizacje. W DFD są one zazwyczaj przedstawiane jako prostokąty.
2. Procesy (Transformacje)
Procesy przekształcają dane wejściowe w dane wyjściowe. Są to aktywne elementy systemu. W DFD są one zazwyczaj przedstawiane jako koła lub zaokrąglone prostokąty. Proces musi mieć co najmniej jedno wejście i jedno wyjście.
3. Przepływy danych (Ruch)
Są to strzałki pokazujące kierunek ruchu danych. Łączą one encje, procesy i magazyny danych. Każdy przepływ musi mieć etykietę opisującą, jakie informacje się przemieszczają (np. „Szczegóły zamówienia”).”
4. Magazyny danych (Pamięć)
Są to miejsca, w których dane są przechowywane do późniejszego użycia. Są to pasywne repozytoria. W DFD są one często przedstawiane jako prostokąty z otwartym końcem lub równoległe linie. Magazyn danych nie inicjuje akcji; czeka na odczyt lub zapis.
Proces tłumaczenia: Od słów do linii 🛠️
Przekształcenie tekstu w diagram wymaga systematycznego podejścia. Proces ten obejmuje dekompozycję i abstrakcję. Nie rysujesz całego systemu na raz. Zaczynasz od wysokiego poziomu i schodzisz w dół.
Krok 1: Określ granice systemu
Zdecyduj, co znajduje się wewnątrz systemu, a co na zewnątrz. Wszystko wewnątrz to proces, magazyn lub przepływ. Wszystko na zewnątrz to encja zewnętrzna. Ta granica jest kluczowa dla określenia kontekstu.
Krok 2: Zidentyfikuj kontekst
Stwórz Diagram kontekstowy (znany również jako DFD poziomu 0). Jest to najwyższy poziom abstrakcji. Pokazuje cały system jako pojedynczy proces oraz jego interakcje z podmiotami zewnętrznymi.
- Proces:Nazwa całego systemu.
- Podmioty:Wszystkie zewnętrzne źródła i odbiorniki.
- Przepływy:Główne dane wejściowe i wyjściowe.
Krok 3: Podział procesu
Gdy kontekst zostanie ustalony, podziel pojedynczy proces na główne podprocesy. Jest to DFD poziomu 1. Każdy podproces powinien obsługiwać odrębną funkcję wynikającą z wymagań. Upewnij się, że dane wprowadzane na poziomie najwyższym również trafiają do jednego z podprocesów.
Krok 4: Dodaj szczegóły i magazyny danych
Gdy schodzisz głębiej do poziomu 2 i wyżej, wprowadzasz magazyny danych. To tutaj logika staje się szczegółowa. Określasz, gdzie dane spoczywają między krokami. Upewnij się, że każdy magazyn danych jest połączony z co najmniej jednym procesem (nie można utworzyć miejsca przechowywania bez możliwości jego aktualizacji lub odczytu).
Wyjaśnienie poziomów abstrakcji 📊
DFD są hierarchiczne. Pozwala to interesariuszom przeglądać system na poziomie odpowiednim dla ich zrozumienia. Poniższa tabela przedstawia różnice między standardowymi poziomami.
| Poziom | Zakres | Główny nacisk | Typowa grupa odbiorców |
|---|---|---|---|
| Diagram kontekstowy | System jako całość | Główne dane wejściowe i wyjściowe | Interesariusze, Zarząd |
| Poziom 1 | Główne funkcje | Kluczowe procesy i magazyny danych | Kierownicy projektów, Architekci |
| Poziom 2 | Podprocesy | Specyficzne transformacje danych | Programiści, Analitycy |
| Poziom 3+ | Procesy atomowe | Szczegółowy przepływ logiki | Inżynierowie |
Zauważ, że złożoność rośnie wraz ze wzrostem numeru poziomu. Diagram kontekstowy zapewnia widok z góry, podczas gdy głębsze poziomy dostarczają szczegółowych mechanizmów.
Zapewnianie spójności i równowagi ⚖️
Jedną z najważniejszych zasad w modelowaniu DFD jest równoważenie. Gdy rozkładasz proces, wejścia i wyjścia procesu nadrzędnego muszą odpowiadać sumie wejść i wyjść procesów podrzędnych. Nie można tworzyć ani niszczyć danych z niczego.
Jeśli proces poziomu 1 przyjmuje „Logowanie użytkownika
Techniki walidacji
Jak dowiedzieć się, że model jest poprawny? Walidacja obejmuje kilka sprawdzianów:
- Weryfikacja przepływu: Śledź każdą strzałkę od źródła do celu. Czy ma to sens? Czy istnieje proces, który ją obsłuży?
- Pokrycie bytów: Czy wszystkie byty zewnętrzne są przedstawione na diagramie kontekstowym?
- Wykorzystanie magazynów danych: Czy każdy magazyn danych jest dostępny? Niepodłączone magazyny to często martwy kod.
- Mapowanie wymagań: Czy możesz śledzić każde wymaganie z powrotem do procesu lub przepływu na diagramie?
Wyzwania w modelowaniu przepływów danych ⚠️
Tworzenie tych modeli nie zawsze jest proste. Analitycy często napotykają przeszkody, które mogą zahamować postępy lub prowadzić do nieprecyzyjnych reprezentacji.
Niejednoznaczność wymagań
Jeśli wstępne wymagania są niejasne, diagram również będzie niejasny. Na przykład „Przetwarzanie zamówienia” jest zbyt ogólne. Czy oznacza to „Odbiór zamówienia”, „Weryfikację zapasów
Rozrost zakresu
Podczas fazy modelowania często pojawiają się nowe wymagania. Jest pokusa, aby dodać je natychmiast. Jednak dodanie zbyt wielu szczegółów zbyt wcześnie może zasłaniać diagram. Lepiej jest ująć nowe wymagania w backlogu i rozwiązać je w następnej iteracji modelu.
Pomyłka z przepływem sterowania
Pospolitym błędem jest mieszanie logiki sterowania z przepływem danych. DFD pokazują co się przemieszcza, a nie kiedy się przemieszcza. Diagramy przepływu sterowania (takie jak schematy blokowe) pokazują gałęzie logiki (jeśli/inaczej). DFD zakładają, że proces zachodzi; pokazują jedynie przepływ danych. Skup się na ładunku danych, a nie na logice decyzyjnej.
Utrzymywanie modelu w czasie 🔄
Wymagania się zmieniają. Systemy ewoluują. DFD nie jest statycznym artefaktem, który rysuje się raz i archiwizuje. Musi być utrzymywany jako żywy dokument.
Gdy wymagania ulegną zmianie, prześledź ich wpływ. Jeśli dodano nowe pole danych, czy zmienia to przepływ? Czy wymaga nowego magazynu? Zaktualizuj diagram natychmiast. Dzięki temu dokumentacja będzie zgodna z rzeczywistością.
Kontrola wersji jest również niezbędna. W miarę rozwoju modelu starsze wersje stają się istotne dla audytu lub zrozumienia dziedzicznej logiki. Oznaczanie wersji (np. DFD_v1.0, DFD_v2.0) pomaga śledzić ewolucję projektu systemu.
Najlepsze praktyki dla jasności ✨
Aby model spełniał swoje zadanie, przestrzegaj tych wytycznych dotyczących skutecznej komunikacji.
- Nazywaj wszystko: Podmioty, procesy i przepływy muszą mieć jasne, opisowe nazwy. Unikaj skrótów, chyba że są one standardem branżowym.
- Ogranicz złożoność: Jeśli pojedynczy proces ma więcej niż siedem wejść lub wyjść, prawdopodobnie jest zbyt złożony. Rozłóż go dalej.
- Minimalizuj przecinające się linie: Choć nie zawsze jest to możliwe, staraj się ułożyć diagram tak, aby strzałki nie przecinały się nadmiernie. Zwiększa to czytelność.
- Używaj spójnych symboli: Trzymaj się jednego stylu notacji (np. Gane & Sarson lub Yourdon & DeMarco) przez cały dokument.
Podsumowanie dotyczące projektowania systemów 🏁
Podróż od wymagań do modelu przepływu danych to dyscyplina jasności. Wymaga ona usunięcia szumu implementacji, aby zobaczyć rdzenny ruch informacji. Przestrzegając zasad dekompozycji, równoważenia i walidacji, tworzysz plan, któremu inżynierowie mogą ufać, a zainteresowane strony mogą zrozumieć.
Ten model staje się punktem odniesienia dla projektowania baz danych, definicji API i specyfikacji interfejsów. Utrwalony w rzeczywistości, stanowi fundament projektu. Gdy wymagania są solidne, diagram jest mapą, która kieruje zespół do celu. Skup się na danych, szanuj granice i upewnij się, że każda strzałka opowiada historię.